Data Engineering
[데이터플랫폼] 웨어하우스·레이크·레이크하우스·마트의 차이 - 1편
쇼핑몰의 주문·클릭 데이터를 따라가며 데이터 웨어하우스, 레이크, 레이크하우스, 마트에 실제로 무엇을 저장하고 어떻게 조회·갱신하는지 살펴본다.
목차
데이터 웨어하우스, 데이터 레이크, 레이크하우스, 데이터 마트. 정의만 읽으면 모두 데이터를 모아 분석하는 곳처럼 느껴진다. 실제로 어떤 테이블이나 파일을 만들고, 분석가가 그것을 어떻게 쓰는지까지 봐야 차이가 드러난다.
웨어하우스는 여러 원천을 공통된 분석 모델로 통합하는 시스템이고, 레이크는 다양한 데이터를 파일·객체로 보관하고 활용하는 기반이다. 레이크하우스는 레이크 위에서 테이블을 신뢰성 있게 관리하고 분석하는 구조다. 마트는 특정 부서나 주제에 맞춰 제공하는 데이터 영역이다. 특히 마트는 앞의 세 가지와 같은 층위의 대안이 아니다. 웨어하우스나 레이크하우스 안에도 마트를 만들 수 있다.
가상의 쇼핑몰에서 주문·결제·클릭 데이터를 다룬다고 가정하고, 이 네 개념을 구체적인 데이터 모습과 함께 살펴보자.
주문을 저장하는 일과 매출을 분석하는 일
고객이 주문하면 서비스는 주문 번호, 상품, 수량을 기록하고 결제 상태를 갱신한다. 이때는 주문 한 건을 정확하게 처리하고 빠르게 조회하는 일이 중요하다. 이런 거래 처리 작업을 OLTP(Online Transaction Processing) 라고 부른다.
분석팀은 “지난달 상품 분류별 매출은 얼마였을까?”, “광고를 보고 들어온 고객이 어떤 상품을 샀을까?”를 묻는다. 많은 주문을 읽고 상품·광고 정보와 연결해 집계하는 OLAP(Online Analytical Processing) 작업이다.
운영 데이터베이스에서도 이런 쿼리를 실행할 수 있다. 다만 넓은 범위를 읽는 분석이 고객 요청 처리와 같은 자원을 쓰면 서로 영향을 줄 수 있다. 여러 서비스에 흩어진 정보를 연결하고 과거 데이터를 보존해야 하는 문제도 있다. 그래서 분석용 데이터를 별도로 준비한다.
이 쇼핑몰에는 주문과 주문상품 테이블, 결제와 환불 내역, 상품 목록, 웹 클릭 로그가 따로 있다. 어디에 어떻게 모으느냐에 따라 분석가가 해야 할 일도 달라진다.
데이터 웨어하우스: 분석할 수 있는 공통 테이블로 통합하기
데이터 웨어하우스(Data Warehouse)는 여러 원천의 데이터를 통합해 분석과 보고에 사용하도록 구성한 저장·분석 시스템이다. 사용자는 보통 테이블 이름과 컬럼을 보고 SQL을 작성한다. 원천마다 다른 식별자와 자료형을 맞추고, 여러 팀이 같은 기준으로 해석할 수 있는 모델을 만드는 일이 중요하다. 웨어하우스와 레이크의 개념
실제로 어떤 테이블이 들어갈까
주문 시스템에서는 주문 번호가 order_id, 결제 시스템에서는 order_number일 수 있다. 결제가 여러 번 시도되거나 한 주문이 부분 환불되기도 한다. 두 테이블을 그대로 조인하면 주문 금액이 중복 집계될 수 있으므로, 분석에 필요한 단위로 먼저 정리해야 한다.
이 예제에서는 주문에 포함된 상품 한 항목당 한 행을 가진 fact_order_item 테이블을 만든다. paid_amount는 할인 등을 반영한 해당 항목의 결제 금액, refunded_amount는 데이터 갱신 시점까지 누적된 환불 금액으로 정한다.
| order_id | item_no | order_date | product_id | paid_amount | refunded_amount |
|---|---|---|---|---|---|
| O1001 | 1 | 2026-09-28 | P10 | 30000 | 0 |
| O1001 | 2 | 2026-09-28 | P20 | 20000 | 5000 |
| O1002 | 1 | 2026-09-28 | P10 | 30000 | 0 |
주문은 두 건이지만 행은 세 개다. 이 테이블에서 COUNT(*)를 하면 주문 건수가 아닌 주문상품 항목 수가 나온다. 테이블 이름만큼이나 한 행의 의미를 정하는 일이 중요한 이유다.
상품의 이름과 분류는 dim_product에 둔다. 이 예제에서는 상품별로 한 행만 있고 분류가 바뀌지 않는다고 가정한다.
| product_id | product_name | category |
|---|---|---|
| P10 | 면 티셔츠 | 의류 |
| P20 | 캔버스 가방 | 잡화 |
주문처럼 발생한 사실과 금액을 담는 테이블을 팩트 테이블, 상품·고객처럼 분석 기준이 되는 속성을 담는 테이블을 차원 테이블이라고 한다. 팩트와 여러 차원 테이블을 연결하는 대표적인 모델이 스타 스키마다. 모든 웨어하우스가 반드시 이 모델을 써야 하는 것은 아니다. 팩트·차원과 스타 스키마
분석가는 원천 결제 시스템을 다시 해석하는 대신, 준비된 두 테이블로 상품 분류별 금액을 구한다. 다음은 위 예시 테이블이 이미 있다는 전제의 SQL이다.
| |
위 세 행을 집계하면 9월 28일의 의류는 60,000원, 잡화는 15,000원이다. 여기서 net_sales는 주문일 기준으로 묶은 결제 금액에서 누적 환불액을 뺀 값이다. 나중에 환불이 추가되면 과거 주문일의 값도 바뀐다. 환불이 발생한 날짜의 현금 흐름을 보고 싶다면 환불 내역을 별도 날짜 기준으로 모델링해야 한다. SQL이 같아도 매출의 정의가 다르면 같은 지표가 아니다.
테이블은 어떻게 만들어지고 유지될까
수집 작업이 원천의 신규·변경 데이터를 가져오면, 변환 작업이 식별자와 자료형을 맞추고 결제·환불을 항목별로 정리한다. 그 결과로 팩트와 차원 테이블을 갱신하고 분석가와 대시보드가 조회한다. 예를 들어 매일 새벽 갱신하는 구성이라면 낮에 발생한 환불은 다음 갱신 전까지 보고서에 반영되지 않는다.
변환 후 적재하는 ETL과 먼저 적재한 뒤 변환하는 ELT 중 어느 순서를 쓰든 웨어하우스를 구성할 수 있다. ETL·ELT는 추출(Extract), 변환(Transform), 적재(Load)의 순서이고, 웨어하우스는 그렇게 만든 데이터의 구성과 활용에 관한 개념이다.
웨어하우스에는 합계만 저장하지 않는다. 위처럼 상세 행을 남겨야 상품·고객 등 새로운 기준으로 다시 집계하고, 이상한 숫자의 원인을 추적할 수 있다. 대신 원천 변경을 반영하는 작업과 모델 관리가 필요하다. 웨어하우스 제품을 도입하는 것만으로 중복 처리나 매출 기준이 정해지지는 않는다.
데이터 레이크: 파일로 남겨 두고 필요한 방식으로 읽기
데이터 레이크(Data Lake)는 여러 형태의 데이터를 보관하고 여러 목적으로 활용하는 저장 구조다. 클라우드에서는 객체 스토리지를 기반으로 구성하는 경우가 많다. 객체 스토리지는 파일의 내용과 그 파일을 가리키는 키를 저장한다. 분석가는 SQL 테이블만 보는 대신, 원본 JSON이나 로그, 정제된 데이터 파일에 접근할 수도 있다.
저장소를 열면 어떤 모습일까
같은 쇼핑몰 데이터를 레이크에 보관한다면 다음과 같은 경로를 만들 수 있다. 실제 서비스의 경로가 아니라 역할을 설명하기 위한 예시다. /로 나눈 부분은 객체 키의 접두사로, 폴더처럼 묶어서 볼 수 있다.
| |
raw에는 수집한 원본, curated에는 자료형이나 중복 등을 정리한 결과를 둔다는 약속이다. 이 이름이 레이크의 필수 규격은 아니다. 레이크에도 정제 데이터와 분석용 데이터가 함께 있을 수 있다.
클릭 파일에 들어 있는 이벤트 하나는 다음처럼 생겼다고 하자.
| |
지금은 일별 매출만 보더라도 이 기록을 남겨 두면 나중에 “상품을 보고 구매하기까지 얼마나 걸리는가?”를 분석할 재료가 생긴다. 물론 주문에도 연결 가능한 고객 식별자가 있어야 하고, 익명 방문이나 기기 변경을 어떻게 처리할지도 정해야 한다. 일별 클릭 수만 남겼다면 이 이벤트의 사용자와 발생 시각을 되살릴 수 없다.
파일이 SQL 테이블이 되는 과정
객체 스토리지가 JSON을 저장했다고 해서 SELECT를 실행해 주는 것은 아니다. 파일을 읽고 해석하고 집계하는 처리·쿼리 엔진이 필요하다. SQL로 읽는 구성에서는 파일 위치, 포맷, 컬럼 등을 테이블 메타데이터로 등록하고 엔진이 그 정보를 이용해 실제 파일에 접근한다. 카탈로그는 이런 테이블 정보를 관리한다. 파일과 테이블 메타데이터의 관계
예를 들어 raw/clicks/의 JSON을 raw_clicks라는 외부 테이블로 등록할 수 있다. 등록 자체가 데이터를 웨어하우스로 복사하거나 중복 이벤트를 제거하는 작업은 아니다. 엔진은 읽을 파일을 정하고 JSON 필드를 컬럼으로 해석한다. 이후 정제 작업에서 event_id 중복을 제거하고 시간대를 맞춘 뒤 결과를 Parquet 같은 분석용 파일 포맷으로 저장할 수 있다.
이처럼 읽을 때 구조를 적용하는 접근을 schema-on-read라고 한다. 반대로 쓰기 전에 컬럼과 자료형을 정하고 검사하는 접근은 schema-on-write다. 원본 JSON을 그대로 보관하면서 정제 테이블에는 엄격한 구조를 적용할 수 있으므로, 한 레이크 안에서도 두 접근을 함께 쓴다.
레이크의 유연함에는 관리할 일도 따른다. event_time의 형식이 바뀌거나 같은 파일이 두 번 수집되면 분석 결과에 영향을 준다. 보관 위치와 소유자, 스키마, 접근 권한을 관리하지 않으면 데이터가 있어도 사용하기 어렵다. 또 원본을 남기는 만큼 저장 공간과 보존 기간을 관리하고, 반복해서 읽고 정제하는 연산 비용도 고려해야 한다.
레이크하우스: 레이크의 파일을 일관된 테이블로 읽고 갱신하기
레이크의 정제 영역에 주문상품 Parquet 파일을 저장했고 SQL로 조회할 수도 있다고 하자. 이제 부분 환불이 들어와 O1001의 금액을 바꾸려 한다. 기존 파일을 지우고 새 파일을 올리는 도중 대시보드가 읽으면 어떤 결과가 나올까? 기존 파일과 새 파일을 함께 읽으면 중복이 생길 수 있고, 기존 파일만 삭제된 시점에는 일부 주문이 빠질 수 있다.
파일을 읽을 수 있는 것과, 여러 작업이 함께 쓰는 테이블의 상태를 안전하게 바꾸는 것은 다른 문제다. 레이크하우스(Lakehouse)는 레이크 기반 저장에 트랜잭션·스키마·메타데이터 관리와 분석 기능을 결합해, SQL 보고와 데이터 과학 작업 등이 공통 데이터를 사용하도록 구성하는 아키텍처다. 레이크하우스의 구조
파일 목록에 테이블의 버전을 더한다
대표적인 테이블 관리 기술로 Apache Iceberg와 Delta Lake가 있다. 세부 저장 방식은 다르지만, 데이터 파일만 두는 대신 어떤 파일들이 한 시점의 테이블을 구성하는지를 메타데이터나 로그로 관리한다. Parquet가 파일 안에 행과 컬럼을 담는 형식이라면, 이런 테이블 계층은 여러 파일을 하나의 테이블 상태로 다루는 규칙을 제공한다. Iceberg의 신뢰성 모델, Delta Lake 개요
Iceberg처럼 스냅샷으로 테이블 상태를 관리하는 방식에서, 파일을 교체하는 갱신을 단순화하면 다음과 같다. 스냅샷은 매번 데이터를 전부 복사한다는 뜻이 아니라, 해당 버전을 구성하는 파일을 가리키는 정보다.
- 현재 스냅샷은 주문상품 파일 A와 B를 가리킨다.
- 작업이 환불을 반영한 새 파일 B′를 쓴다. 이 시점에는 현재 스냅샷이 그대로다.
- A와 B′를 가리키는 새 스냅샷을 커밋해 현재 상태로 반영한다.
- 갱신 전 스냅샷을 선택한 조회는 A와 B를, 새 스냅샷을 선택한 조회는 A와 B′를 읽는다.
이 과정에서 테이블 전체를 복사할 필요는 없다. 바뀌지 않은 A는 재사용한다. 실제 행 변경을 표현하는 방법은 포맷·버전·엔진에 따라 다르며, 모든 갱신이 반드시 파일 전체 교체로 구현되는 것은 아니다.
호환되는 엔진이 테이블의 읽기·쓰기 규약을 지키면, 조회가 파일 교체의 중간 상태를 테이블로 읽는 문제를 피할 수 있다. 커밋 전 실패한 작업의 파일은 현재 테이블에 포함되지 않으며 별도 정리 대상이 될 수 있다. 동시 쓰기에는 충돌 검사와 재시도가 필요할 수 있다. Iceberg의 원자적 커밋과 동시 쓰기
이런 트랜잭션 보장은 테이블 상태를 일관되게 바꾸는 것에 관한 것이다. 동일 이벤트를 두 번 넣거나 환불 계산을 잘못하는 업무 로직까지 자동으로 고치지는 않는다. 메타데이터를 무시하고 저장 경로의 Parquet 파일을 직접 전부 읽어도 같은 보장을 얻는 것은 아니다.
테이블 포맷만으로 완성되지는 않는다
레이크하우스를 운영하려면 파일을 보관할 저장소, 테이블의 위치와 상태를 찾을 카탈로그·메타데이터, 실제 연산을 할 엔진, 권한과 품질을 관리할 체계가 함께 필요하다. 분석가는 SQL로 fact_order_item을 집계하고, 다른 작업은 같은 테이블을 읽어 고객별 구매 특성을 계산하는 식으로 사용한다.
공통 저장 기반을 활용하면 용도마다 데이터를 복제하고 동기화하는 부담을 줄일 여지가 있다. 대신 사용하는 엔진이 테이블 포맷과 해당 기능을 지원하는지 확인해야 한다. 작은 파일이 과도하게 늘지 않도록 정리하고, 조회 패턴에 맞게 데이터를 배치하는 작업도 남는다. 레이크하우스라는 이름만으로 빠른 쿼리나 낮은 비용이 보장되지는 않는다.
여기에도 앞서 본 팩트·차원 모델을 만들 수 있다. 웨어하우스에서 중요했던 분석 모델링은 레이크하우스에서도 필요하다. 레이크와 별도 웨어하우스를 연결해 파일을 복사하는 구성과, 레이크 위의 테이블을 공통 기반으로 분석하는 구성은 구분해서 봐야 한다.
데이터 마트: 특정 팀이 바로 사용할 데이터로 제공하기
데이터 마트(Data Mart)는 특정 부서나 분석 주제에 맞춘 데이터 영역이다. 전사 주문·상품·고객 데이터를 통합한 기반이 있더라도, 모든 사용자가 그 전체 구조를 이해하고 SQL을 작성해야 한다면 활용이 어렵다. 마케팅팀에는 캠페인 성과, 상품팀에는 상품 분류별 판매 현황처럼 필요한 범위와 기준을 정해 제공한다. 데이터 마트의 역할
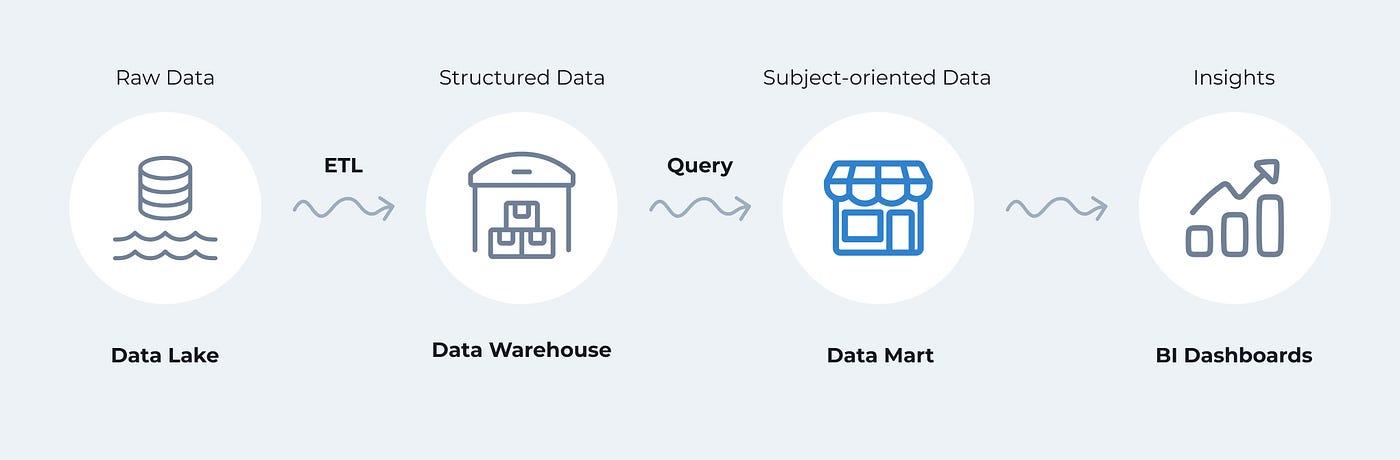
레이크의 원본을 웨어하우스로 통합한 뒤 주제별 마트로 제공하는 구성의 한 예다. 그림의 Query는 필요한 데이터를 조회·가공하는 과정을 단순화한 표현이다. 마트를 뷰로 제공할지, 결과를 테이블로 저장할지는 별도로 정한다. 모든 마트가 레이크와 웨어하우스를 순서대로 거쳐야 하는 것은 아니다.
같은 주문 데이터에서 상품팀의 마트를 만든다면
상품팀이 매일 보는 값이 날짜·상품 분류별 판매 금액이라면 앞의 SQL 결과를 mart_product_daily_sales로 제공할 수 있다. 이 예제 마트의 한 행은 주문상품 한 항목이 아니라 날짜와 상품 분류 한 조합이다.
| order_date | category | net_sales |
|---|---|---|
| 2026-09-28 | 의류 | 60000 |
| 2026-09-28 | 잡화 | 15000 |
대시보드는 결제·환불 연결을 다시 구현하지 않고 이 데이터를 읽는다. 다만 이 마트도 앞서 정한 주문일 기준과 누적 환불 반영 규칙을 따른다. 지표 정의뿐 아니라 언제까지 수집한 데이터를 반영했는지, 갱신이 얼마나 자주 이뤄지는지도 함께 알려야 한다.
마트가 꼭 집계 테이블이어야 하는 것은 아니다. 마케팅팀이 고객별 구매 이력을 분석한다면 그 목적에 맞는 상세 데이터도 마트에 포함할 수 있다. 중요한 것은 크기나 행 수보다 누가 어떤 분석에 쓰도록 구성했는가다.
별도 저장소를 하나 더 만드는 것일까
마트는 같은 웨어하우스나 레이크하우스 안에서 스키마·테이블·뷰의 묶음으로 제공할 수 있다. 별도 시스템으로 복사해서 제공하는 구성도 가능하다.
일반 뷰로 제공하면 조회 정의를 저장하고 사용할 때 원천 테이블을 계산한다. 결과를 테이블로 저장하면 반복 조회에서 집계 부담을 줄일 수 있지만, 원천이 바뀌었을 때 그 결과를 갱신해야 한다. 예제처럼 늦게 들어온 환불이 과거 주문일의 금액을 바꾸는 경우에는 오늘 데이터만 새로 집계해서는 충분하지 않다.
원천 시스템에서 직접 데이터를 가져와 독립적인 마트를 만들기도 한다. 따라서 “마트는 반드시 웨어하우스에서 잘라낸 일부”라고 한정할 수는 없다. 다만 팀마다 별도로 만들면 같은 매출을 다른 기준으로 계산할 위험이 있어, 공통 정의를 맞출 필요가 있다. 종속형·독립형·혼합형 마트
네 개념을 같은 시스템에 놓아 보면
네 가지를 순서대로 거쳐야 하는 단계나 서로 교체하는 제품으로 보면 관계가 꼬인다. 쇼핑몰에서 맡길 수 있는 역할을 비교하면 다음과 같다.
| 개념 | 실제로 다루는 모습 | 쇼핑몰에서 맡는 역할 |
|---|---|---|
| 웨어하우스 | 원천을 통합한 상세·차원·집계 테이블과 SQL 분석 환경 | 주문·결제·상품을 공통 기준으로 분석 |
| 레이크 | 원본 JSON·이미지와 정제된 파일을 보관하는 저장 기반 | 클릭 원본 보존, 재처리와 여러 분석의 재료 제공 |
| 레이크하우스 | 레이크의 파일을 버전·트랜잭션으로 관리하는 테이블과 분석 환경 | 환불 갱신과 조회를 일관되게 수행하고 여러 작업이 데이터 활용 |
| 마트 | 특정 주제에 맞춘 상세·집계 테이블이나 뷰 | 상품팀에 날짜·분류별 판매 데이터를 제공 |
예를 들어 클릭 원본은 레이크에 남기고 주문·결제를 웨어하우스로 통합한 뒤 상품팀 마트를 제공할 수 있다. 다른 구성에서는 레이크 위에 레이크하우스 테이블을 만들고, 그 안에 주문상품 모델과 상품팀 마트를 둘 수 있다. 두 경우 모두 마트는 사용자가 데이터를 소비하는 목적에 맞춘 영역이다.
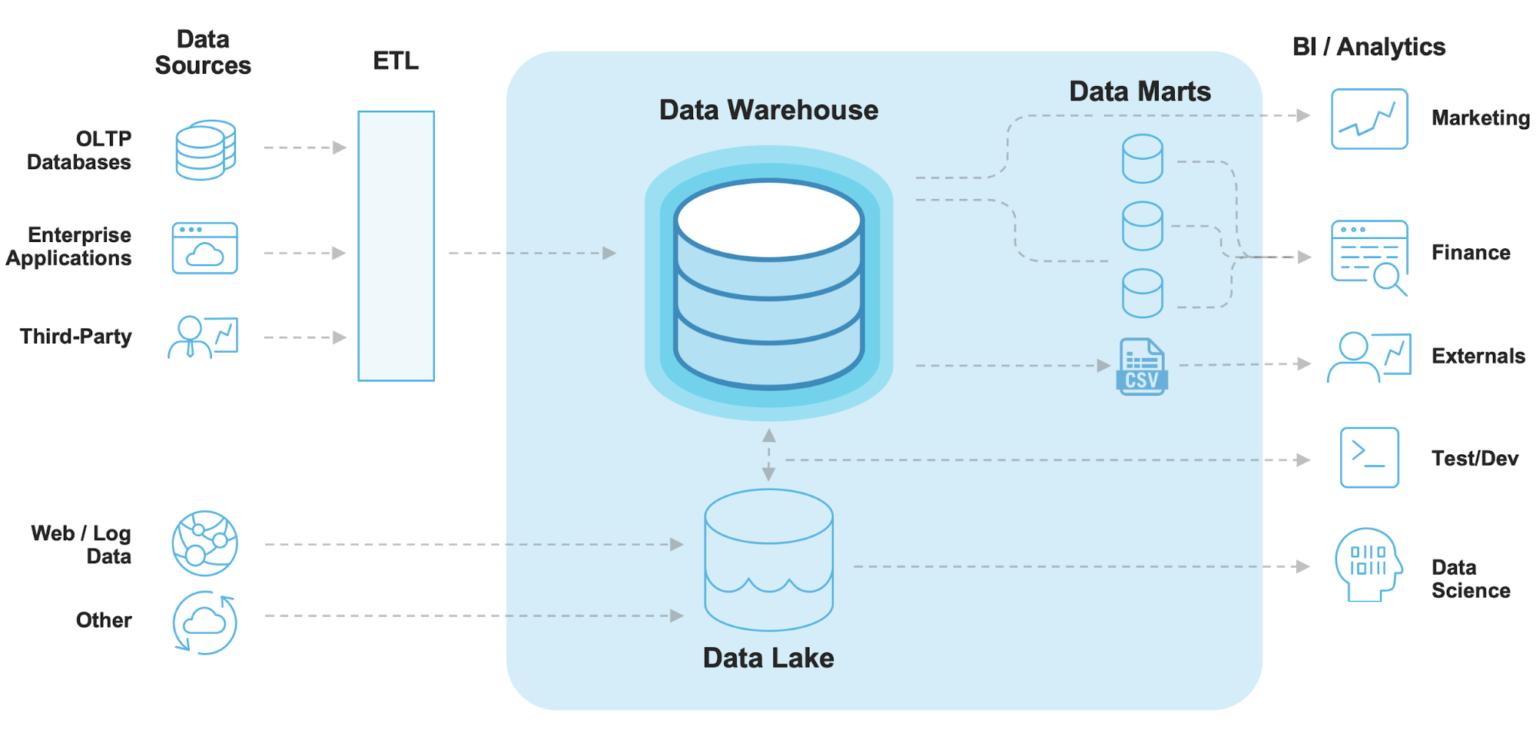
이 그림은 웨어하우스와 레이크를 함께 두고 용도별로 데이터를 제공하는 구성이다. 파란 영역은 함께 운영하는 범위를 묶어 표현한 것이며, 레이크가 반드시 웨어하우스 내부에 있어야 한다는 뜻은 아니다. 두 저장 구조 사이에 데이터를 주고받는 화살표가 있다는 것만으로 레이크하우스가 되는 것도 아니다. 레이크하우스에서는 앞서 설명한 테이블 관리 계층과 그 테이블을 사용하는 분석 환경이 핵심이다.
이미 정의된 매출 보고가 중심이라면 공통 모델과 마트의 품질·갱신 주기를 먼저 살펴볼 만하다. 원본을 다시 처리하거나 새로운 분석을 자주 시도해야 한다면 레이크의 보존·탐색 체계가 중요해진다. 레이크의 데이터를 여러 작업이 테이블로 읽고 갱신해야 한다면 레이크하우스의 테이블 관리와 엔진 구성이 검토 대상이다. 이 요구는 한 시스템 안에 함께 있을 수 있다.
다음 글에서는 이렇게 구성한 데이터를 매일 수집·갱신하고 여러 사람이 사용할 수 있게 운영하는 범위, 데이터 플랫폼을 살펴본다.