Data Engineering
[Databricks] Unity Catalog 권한 모델: GRANT·상속·소유권 이해하기 - 심화 1편
Unity Catalog의 사용자·그룹, USE CATALOG·USE SCHEMA·SELECT, 권한 상속과 소유권을 설명한다. 권한 부여·회수를 실습하고 REVOKE 후에도 조회되는 이유를 추적한다.
목차
분석 담당자에게 판매 집계인 Gold는 보여주고, 원본인 Raw는 보여주지 않으려 한다. 어떤 권한을 줘야 할까? 나중에 담당자가 바뀌면 어떤 권한을 회수해야 할까?
이번 글은 이 상황을 기준으로 Unity Catalog 권한을 살펴본다. 조회에 필요한 권한과 상속 범위를 설명한 뒤, 본인이 만든 테이블에서 SELECT를 회수해도 소유자는 계속 읽을 수 있다는 점을 확인한다. 테이블을 catalog·schema 아래에 구성하는 방법은 기초 2편에서 다뤘다.
설명은 2026년 10월 19일 확인한 Databricks on AWS 공식 문서를 기준으로 작성했다. 1~4절은 개념 설명, 코드 실행은 6절부터 시작한다. 행 필터·컬럼 마스킹과 ABAC 정책은 이후 보안 주제에서 다룬다.
1. GRANT 문장을 세 부분으로 나눠 보기
분석 담당자들을 uc_lab_readers 그룹으로 묶었다고 가정하자. 이 그룹에 Gold 조회 권한을 주는 SQL은 다음과 같다. 문법 설명용 예시이므로 지금 실행하지 않는다.
| |
문장은 다음 순서로 읽으면 된다.
| SQL 부분 | 뜻 | 권한 용어 |
|---|---|---|
TO uc_lab_readers | 누구에게 주는가: 분석 담당자 그룹 | 권한 주체, Principal |
GRANT SELECT | 무엇을 허용하는가: 데이터 조회 | 권한, Privilege |
ON TABLE ...gold_sales | 어디에 적용하는가: Gold 테이블 | 권한 대상 객체, Securable object |
즉, 권한은 특정 주체에게 특정 객체에서 할 수 있는 작업을 허용하는 것이다. SELECT를 받은 그룹의 구성원은 해당 테이블을 조회할 수 있다. 단, 2절에서 설명할 부모 catalog·schema의 사용 권한도 필요하다.
사용자보다 그룹에 부여하는 이유
분석 담당자가 다섯 명이면 다섯 사용자에게 같은 권한을 줄 수도 있다. 하지만 담당자가 늘거나 이동할 때마다 테이블별 부여 내역을 바꿔야 한다. 그룹에 권한을 주면 테이블 권한은 유지하고 그룹 구성원만 바꿀 수 있다.
Unity Catalog에서는 계정에 등록된 사용자·그룹·서비스 프린시펄을 권한 주체로 사용한다. 계정 그룹은 계정 수준에서 관리하는 그룹이며, 특정 workspace 안에서만 관리되는 workspace-local 그룹과 다르다. 이 글의 uc_lab_readers는 Unity Catalog 권한을 받을 수 있는 계정 그룹을 뜻한다. 권한 주체
서비스 프린시펄은 사람이 로그인해서 쓰는 계정 대신 Job·스크립트 같은 자동화에 부여하는 신원이다. 예를 들어 집계 Job에는 쓰기 권한을, 분석가 그룹에는 읽기 권한을 주어 실행 목적에 따라 관리할 수 있다. 사용자·그룹·서비스 프린시펄
예제의 백틱(`)은 그룹명이나 이메일을 SQL 이름으로 감싸는 기호다. 이름에 하이픈이나 @ 같은 문자가 있어도 하나의 주체 이름으로 해석하게 한다.
2. SELECT만 줬는데 왜 조회가 안 될까
이번 Gold의 전체 이름은 workspace.uc_permission_lab.gold_sales다.
| 이름 | 객체 | 포함하는 대상 |
|---|---|---|
workspace | catalog | 여러 schema |
uc_permission_lab | schema | Gold·Raw 같은 테이블 |
gold_sales | table | 판매 집계 데이터 |
이 구조는 테이블의 주소이면서 권한을 부여할 단위다. 여러 테이블을 한꺼번에 관리하려면 schema를, 그보다 큰 데이터 영역을 관리하려면 catalog를 사용한다. 이 계층의 상위에는 객체 메타데이터를 관리하는 metastore가 있지만 테이블 이름에는 포함하지 않는다. Unity Catalog 객체 구조
일반 사용자의 테이블 조회에 필요한 권한
Gold를 읽는 분석 담당자에게는 다음 세 가지가 모두 있어야 한다.
| 권한 | 부여할 대상 | 이 권한이 허용하는 것 |
|---|---|---|
USE CATALOG | workspace catalog | 이 catalog 안의 객체 사용 |
USE SCHEMA | workspace.uc_permission_lab schema | 이 schema 안의 객체 사용 |
SELECT | workspace.uc_permission_lab.gold_sales table | Gold의 데이터 조회 |
USE CATALOG와 USE SCHEMA는 안에 있는 모든 데이터를 읽는 권한이 아니다. 테이블을 사용하기 위한 선행 조건이고, 실제 행을 읽는 작업은 SELECT가 허용한다.
따라서 사용 권한 둘만 주면 Gold를 읽지 못한다. 반대로 Gold SELECT만 주고 필요한 사용 권한이 빠져 있어도 조회하지 못한다. 조회가 실패하면 SELECT뿐 아니라 부모 catalog·schema 권한을 확인해야 하는 이유다. 테이블 조회의 권한 조건
읽기와 쓰기도 따로 부여한다
분석 담당자에게 Gold를 보여주려면 SELECT가 필요하다. 데이터를 고칠 필요가 없다면 MODIFY는 주지 않는다. MODIFY는 기존 테이블에 행을 추가·수정·삭제하는 작업을 허용한다.
새 테이블을 만드는 CREATE TABLE도 별도 권한이다. 새 테이블을 만들 수 있다고 다른 사람이 만든 테이블을 모두 읽거나 수정할 수 있는 것은 아니다. 허용할 작업부터 정한 뒤 그 작업에 맞는 권한을 선택한다. 권한 종류
3. 소유자는 SELECT가 없어도 왜 읽을 수 있을까
여기까지는 다른 사람에게 데이터를 공유하는 상황이었다. 그런데 테이블을 직접 만든 본인은 SELECT를 따로 받은 적이 없어도 조회한다. 테이블의 소유자(Owner) 이기 때문이다.
객체를 만든 주체는 그 객체의 최초 소유자가 된다. 테이블 소유자는 자신의 테이블을 읽고 관리할 수 있으며, 다른 사람에게 권한을 줄 수도 있다. 이 능력은 소유권에서 오므로 본인에게 별도 GRANT SELECT를 실행할 필요가 없다. 객체 소유권
이 차이는 회수할 때 드러난다. 본인에게 SELECT를 명시적으로 줬다가 REVOKE하면 그 SELECT 부여만 사라진다. 소유권은 그대로다. 따라서 조회도 계속된다. 7절에서는 이 상황을 직접 확인한다.
MANAGE로 다른 사람에게 관리를 맡길 수도 있다
분석 담당자는 데이터를 읽기만 하면 되지만, 운영 담당자는 권한을 관리해야 할 수 있다. 이때 사용하는 권한이 MANAGE다. 소유자를 바꾸지 않고도 다른 주체에게 권한 부여·회수, 소유권 이전, 객체 삭제 등의 관리를 맡길 수 있다.
다만 MANAGE 자체가 SELECT를 자동으로 주지는 않는다. 데이터를 읽는 권한과 권한을 관리하는 능력을 분리한 것이다. MANAGE를 받은 주체는 자신에게 SELECT를 줄 수 있으므로, 단순 조회자에게 주는 권한으로 사용하지 않는다. MANAGE
| 분석 담당자가 필요한 일 | 선택할 권한 |
|---|---|
| Gold 데이터 읽기 | Gold의 SELECT와 부모 사용 권한 |
| Gold 데이터 수정 | 필요한 읽기 권한에 더해 MODIFY 검토 |
| 다른 사용자의 Gold 권한 관리 | MANAGE 또는 소유권이 필요한 관리 역할로 분리 |
catalog나 schema 소유자는 그 안의 객체를 관리할 수 있다. 그렇다고 모든 하위 테이블의 소유자가 되는 것은 아니다. 부모 객체를 소유하는 것과 개별 테이블을 소유하는 것은 구분된다.
4. schema에 SELECT를 주면 Raw도 읽게 된다
처음 목표는 Gold만 공유하는 것이다. 이를 위해 SELECT ON TABLE ...gold_sales를 주면 해당 테이블에 적용된다.
반면 SELECT ON SCHEMA workspace.uc_permission_lab을 주면, 그 schema의 현재와 미래의 테이블·뷰에 SELECT가 적용된다. 이를 권한 상속이라고 한다. 별도로 테이블마다 GRANT하지 않아도 같은 권한이 적용되는 것이다. 부모 사용 권한은 앞에서 설명한 대로 필요하다. 권한 상속
| SELECT를 부여한 위치 | 조회가 허용되는 범위 |
|---|---|
gold_sales 테이블 | Gold 하나 |
uc_permission_lab schema | 같은 schema의 Gold·Raw와 나중에 만드는 테이블·뷰 |
테이블이 많고 모두 같은 담당자에게 공개해도 된다면 schema 부여가 편리하다. 하지만 Gold와 Raw의 공개 대상이 다르면 같은 schema에 SELECT를 주는 방식은 너무 넓다. 테이블별로 부여하거나, 접근 대상이 같은 데이터끼리 schema를 나누는 설계를 검토한다.
REVOKE는 다른 경로의 권한까지 없애지 않는다
분석가 그룹에 Gold SELECT와 schema SELECT를 모두 줬다고 하자. 이때 Gold SELECT만 REVOKE해도 그룹은 계속 Gold를 읽는다. schema에서 내려오는 SELECT가 남아 있기 때문이다.
Gold를 읽지 못하게 하려면 남아 있는 schema 부여도 회수해야 한다. 사용자에게 직접 준 SELECT를 회수했는데 소속 그룹에 SELECT가 남아 있는 경우도 같다. 다른 허용 경로가 남아 있으면 계속 조회할 수 있다. REVOKE
따라서 권한 회수는 명령 실행 성공으로 끝나지 않는다. 어느 주체에게 어느 객체에서 준 권한을 지웠는지 확인하고, 권한을 회수한 사용자로 다시 조회해야 한다.
5. 이번에 실행할 실습 범위
앞 편과 같은 Free Edition의 Serverless Notebook에서 본인 계정 하나로 진행한다.
- Gold 테이블을 만들고 실행 사용자와 테이블 소유자가 같은지 확인한다.
- SHOW GRANTS로 명시적인 권한 부여 내역을 확인한다.
- 본인에게 SELECT를 부여했다가 회수하고, 소유권이 유지되므로 조회가 계속되는지 확인한다.
이 실습에서 확인할 것은 SELECT 부여 내역과 소유권은 별개라는 점이다. 다른 사용자의 접근 허용·차단을 검증하는 실습은 포함하지 않는다.
6. 권한을 바꾸기 전 상태 확인하기
Workspace에 uc_permission_lab 폴더와 Python Notebook 01_permissions 를 만든다. Compute는 Serverless로 선택한다. 기본 실습은 이 Notebook 하나에서 진행한다.
실습 테이블 생성
첫 SQL 셀에 아래 코드를 넣고 한 번 실행한다.
| |
Gold는 3행·합계 450.00이다. 이후 SELECT를 회수한 뒤에도 이 결과가 조회되는지 비교한다.
이 준비 셀은 최초 한 번만 실행한다. 이후 권한을 바꿀 때는 해당 단계의 새 셀을 실행한다.
현재 계정이 테이블 소유자인지 확인
새 Python 셀에서 실행한다.
| |
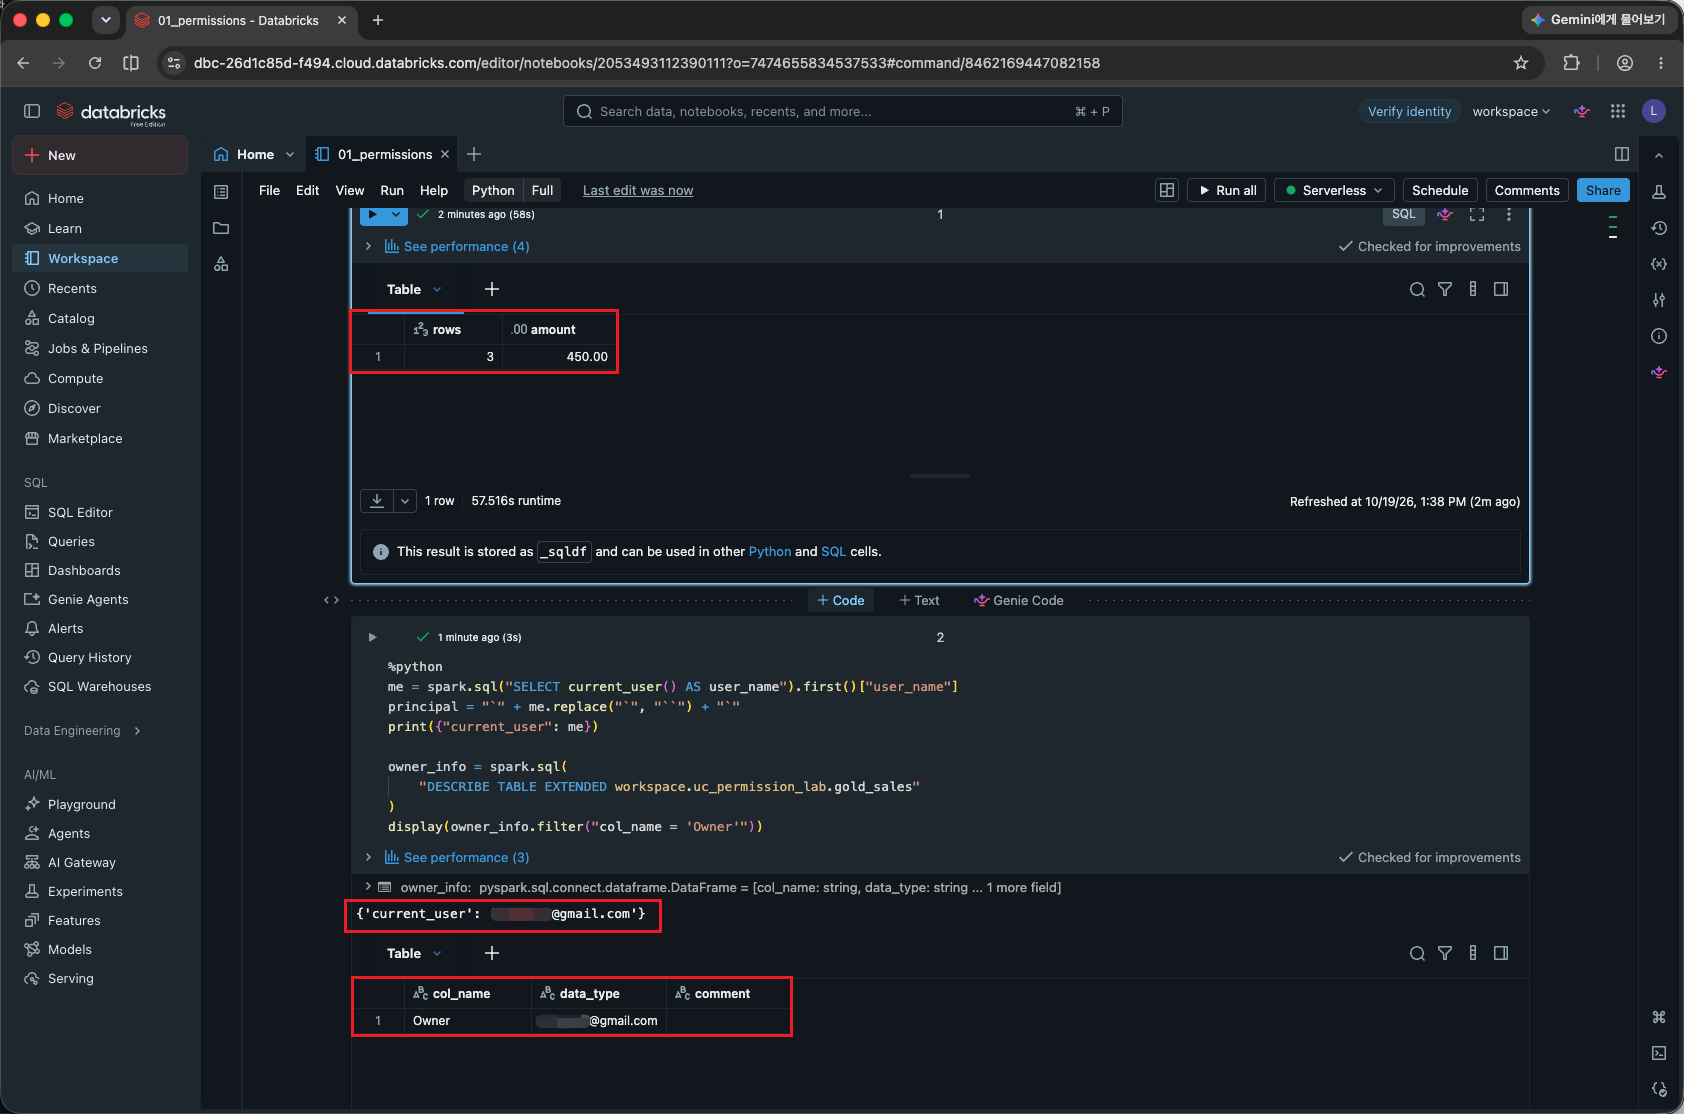
출력의 current_user는 지금 코드를 실행한 사용자, Owner는 Gold 테이블의 소유자다. 두 값이 같으면 현재 계정이 만든 테이블을 본인 소유자 권한으로 조회하고 있는 것이다. 소유자 조회
코드의 me에는 현재 계정 이름을 저장한다. principal은 그 이름을 백틱으로 감싸 SQL의 TO·FROM 뒤에 넣을 준비를 한 값이다. 다음 절에서 본인에게 권한을 주고 회수할 때 그대로 사용하므로 같은 Notebook에서 이어서 실행한다.
SHOW GRANTS로 권한을 부여하기 전 상태 확인
이제 누구에게 어떤 권한이 부여되어 있는지 조회한다. 다음 절에서 SELECT를 추가하고 지웠을 때와 비교하기 위해, 변경 전 상태부터 보는 것이다.
새 Python 셀에서 실행한다.
| |
코드는 catalog·schema·table에 대해 SHOW GRANTS를 한 번씩 실행한다. 테이블만 보지 않고 상위 객체도 조회하는 이유는 schema나 catalog에서 받은 권한이 테이블까지 적용될 수 있기 때문이다. SHOW GRANTS
이번 실행에서는 catalog·schema·table 결과가 모두 No rows returned, 즉 0행이었다. 현재 SHOW GRANTS가 보여 주는 부여 내역이 없다는 뜻이다.
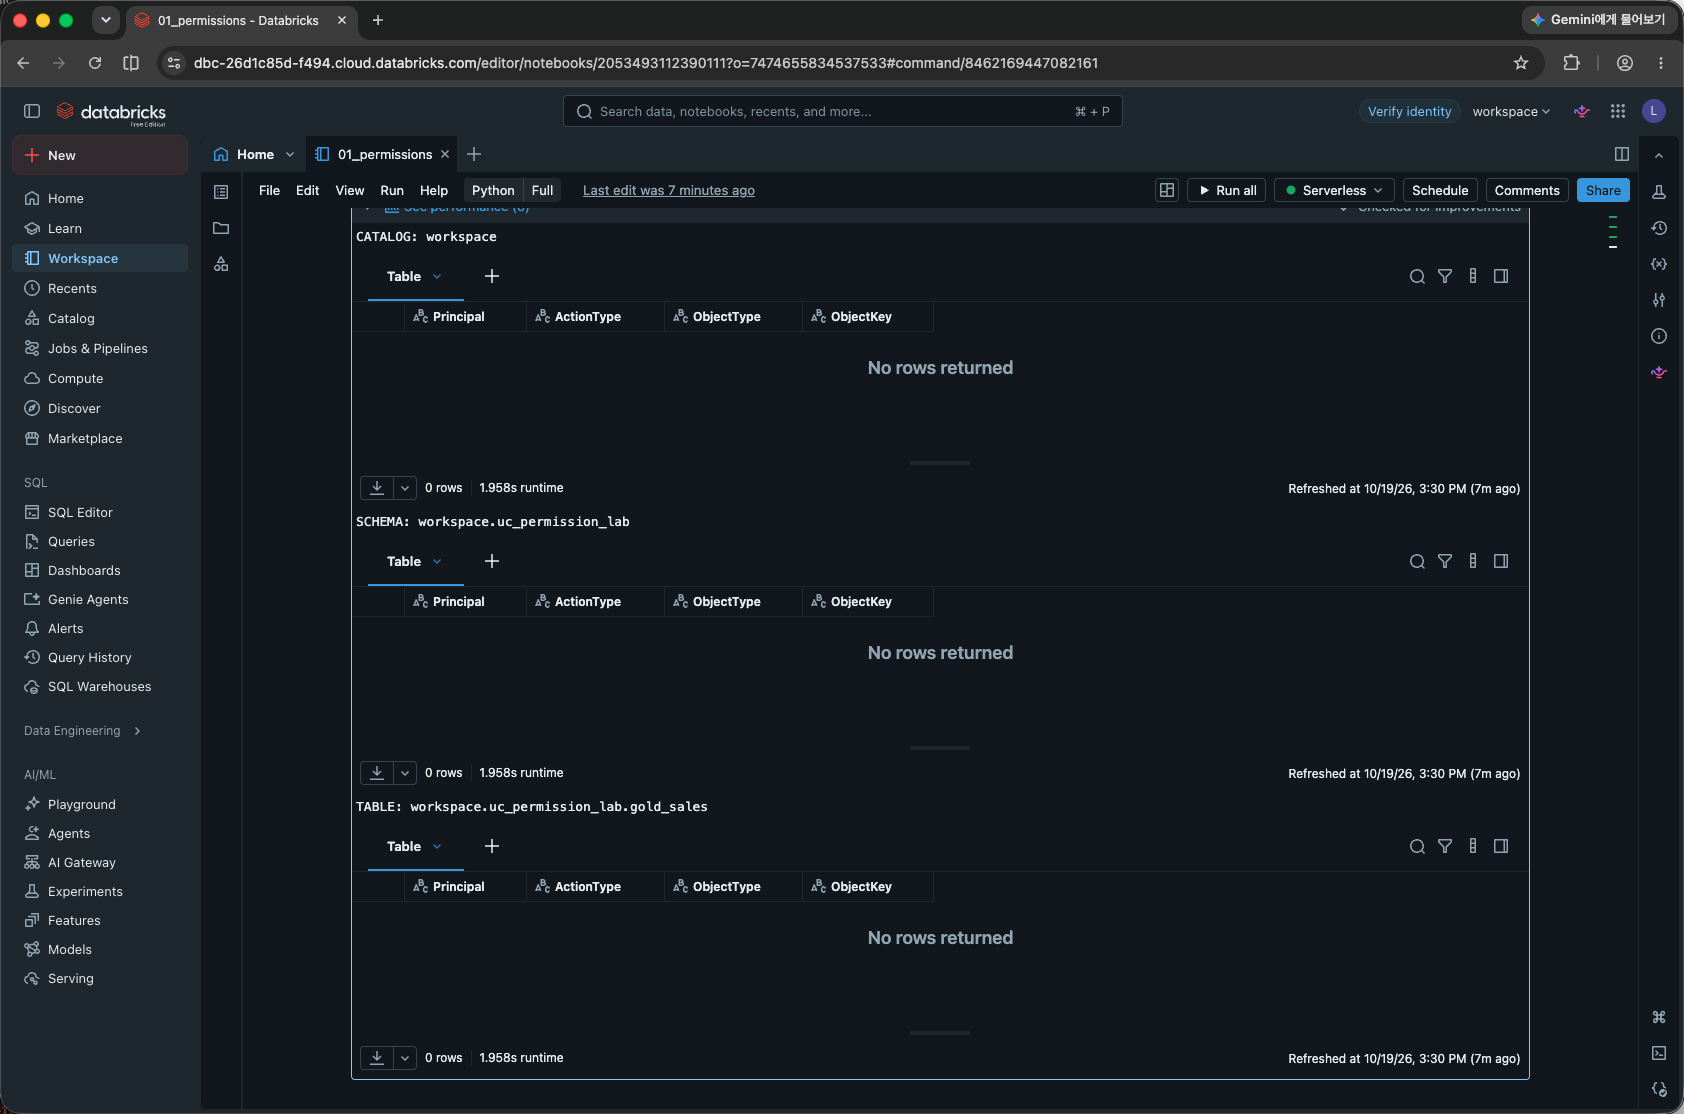
이 결과는 다음 절의 권한 변경 전 비교 기준이다. 본인에게 SELECT를 부여하면 한 행이 나타나고, 회수하면 다시 사라지는지 확인한다.
Gold 데이터가 없다는 뜻은 아니다. 앞에서는 이미 3행·450.00을 조회했고, 실행 사용자와 Owner가 같은 것도 확인했다. 소유권에 따른 조회 능력은 명시적인 GRANT 내역과 별개이므로, 목록이 비어 있어도 소유자는 읽을 수 있다.
7. SELECT 부여·회수와 소유권을 비교하기
이번 실험에서는 테이블 소유자는 그대로 두고, 명시적으로 부여하는 SELECT만 바꾼다. 회수 후에도 조회가 성공한다면 소유권과 SELECT 부여가 별개라는 설명을 실제 결과와 연결할 수 있다.
본인에게 SELECT 부여
같은 Notebook의 새 Python 셀에서 실행한다.
| |
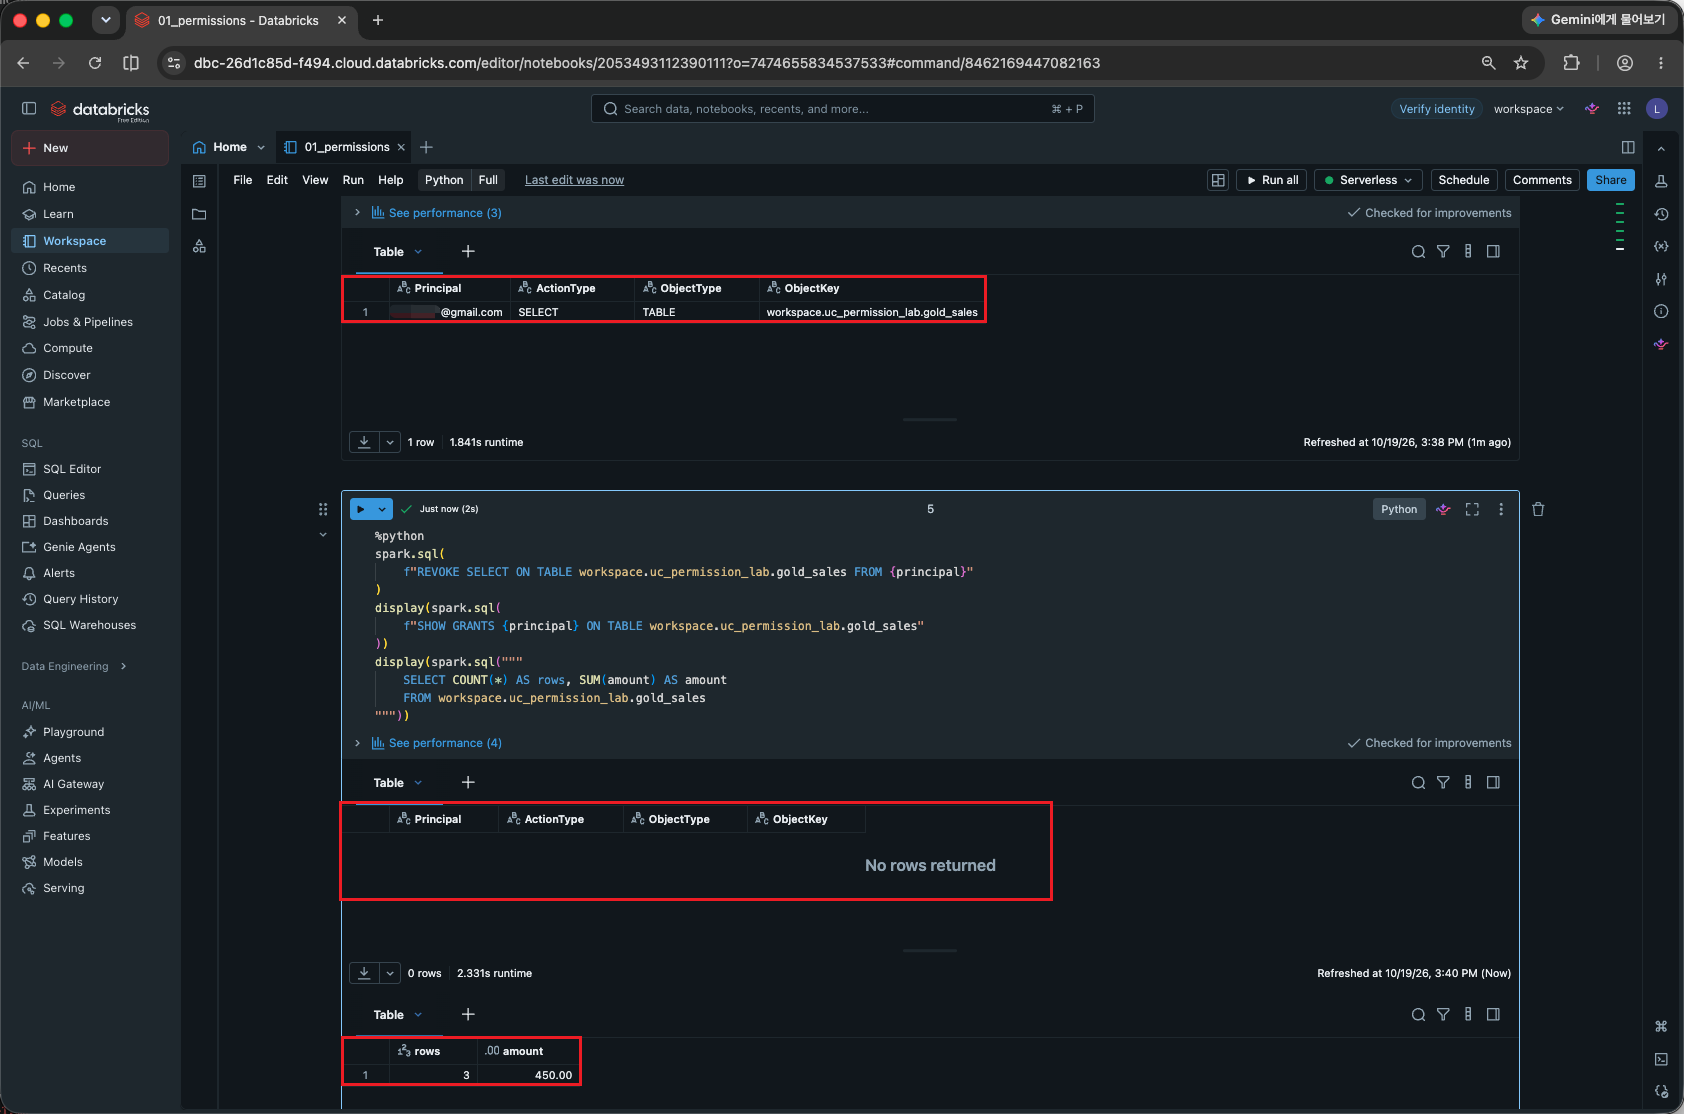
GRANT는 6절에서 확인한 현재 계정에 Gold SELECT를 부여한다. 이어지는 SHOW GRANTS는 방금 부여한 SELECT가 표시되는지 확인하는 조회다. 이번 실행에서는 본인 이메일·SELECT·TABLE·workspace.uc_permission_lab.gold_sales가 한 행으로 표시됐다. 누가 어떤 작업을 어느 테이블에서 허용받았는지를 나타낸다. GRANT
현재 계정은 이미 소유자이므로 이 명령 전에도 Gold를 읽을 수 있었다. 여기서 달라지는 것은 읽기 가능 여부가 아니라 명시적인 SELECT 부여 내역이다.
방금 부여한 SELECT 회수
다음 Python 셀에서 실행한다.
| |
이 셀은 세 작업을 차례로 한다.
- 본인에게 직접 준 Gold SELECT를 회수한다.
- SHOW GRANTS로 회수 후의 부여 내역을 확인한다.
- Gold를 다시 조회해 읽기 가능 여부를 확인한다.
실행 결과, 부여 내역은 다시 0행이 됐지만 Gold 조회는 여전히 3행·450.00이었다. 직접 준 SELECT만 회수했고 Owner는 바꾸지 않았기 때문이다.
| 비교할 것 | GRANT 전 | GRANT 후 | REVOKE 후 |
|---|---|---|---|
| 본인에게 직접 준 테이블 SELECT | 부여 전 | 부여됨 | 회수됨 |
| 테이블 소유자 | 현재 계정 | 현재 계정 | 현재 계정 |
| 소유자의 Gold 조회 | 가능 | 가능 | 가능 |
따라서 소유자 본인의 조회 성공만으로 다른 사람의 접근 권한을 판단할 수 없다.
8. 권한을 설계할 때 확인할 것
Gold만 공개하려면 테이블 또는 schema 구성을 선택한다
같은 schema에 Gold와 Raw가 섞여 있고 Gold만 공유하려면 Gold 테이블에 SELECT를 준다. 여러 Gold를 같은 분석가 그룹에 공개하려면 Gold 전용 schema를 두고 schema SELECT를 주는 방법도 있다.
이때 기준은 최소 권한 원칙, 즉 업무에 필요한 대상과 작업만 허용하는 것이다. 테이블별 부여는 대상을 세밀하게 고를 수 있지만 관리할 항목이 늘어난다. schema 부여는 관리가 단순하지만 미래에 들어오는 테이블까지 같은 공개 범위가 된다. 앞으로 어떤 데이터가 그 schema에 들어올지도 고려해 선택한다. 권한 설계
테이블이 보이는 것과 읽히는 것은 다르다
Catalog Explorer에서 테이블 이름을 볼 수 있지만 SELECT가 실패할 수 있다. 객체 이름과 설명을 찾아보는 BROWSE와 행을 읽는 SELECT가 다른 권한이기 때문이다. BROWSE만 있는 사용자에게 조회를 허용하려면 2절의 사용 권한과 SELECT를 따로 확인한다.
ALL PRIVILEGES로 해결하기 전에 작업 범위를 정한다
권한 오류를 빨리 해결하려고 ALL PRIVILEGES를 주면 분석 담당자에게 필요하지 않은 수정 권한까지 허용할 수 있다. 이 글의 목표는 읽기 공유이므로 SELECT와 필요한 사용 권한을 준다.
ALL PRIVILEGES는 소유권과도 다르다. 해당 객체의 여러 권한을 묶지만 MANAGE, READ METADATA, EXTERNAL USE SCHEMA, EXTERNAL USE LOCATION은 포함하지 않는다. 모든 권한이라는 이름만 보고 소유자와 같다고 해석하지 않는다. ALL PRIVILEGES
조회가 예상과 다르면 실제 실행 계정부터 본다
권한을 줬는데 읽지 못하거나 회수했는데 계속 읽는다면 다음 순서로 확인한다.
| 순서 | 확인할 질문 | 확인하는 이유 |
|---|---|---|
| 1 | current_user()가 확인하려는 사용자와 같은가? | 소유자로 실행한 결과를 다른 사용자의 접근 결과로 착각하지 않기 위해 |
| 2 | 부모 USE 권한과 대상 SELECT가 있는가? | SELECT만 주고 사용 권한을 빠뜨리지 않았는지 보기 위해 |
| 3 | Owner이거나 다른 그룹·상위 객체의 SELECT가 남아 있는가? | 회수한 경로 외에 읽기를 허용하는 경로를 찾기 위해 |
SHOW GRANTS로 부여 내역을 조사할 때는 실행자의 권한에 따라 전체 내역을 보지 못할 수 있다. 다른 사용자의 권한을 조사해야 한다면 객체 소유자나 권한 관리 담당자가 확인한다. 내가 본 목록이 비어 있다는 사실만으로 그 사용자의 모든 접근 경로가 없다고 결론내리지 않는다. 권한 내역 조회 범위
마지막으로 Notebook을 여는 권한과 테이블을 읽는 권한은 별개다. Job에서는 실행 버튼을 누른 사람과 데이터 접근에 쓰이는 실행 주체가 다를 수 있으므로 Run as 설정과 작업의 실행 방식도 확인한다. Job 실행 주체
시리즈
Databricks 심화
- [Databricks] Unity Catalog 권한 모델: GRANT·상속·소유권 이해하기 - 심화 1편 현재 글
- [Databricks] 데이터 리니지: 매출의 출처와 변경 영향을 추적하기 - 심화 2편