Data Engineering
[Databricks] AI Functions로 고객 리뷰 분류·추출·요약하기 - 활용 3편
가상 고객 리뷰에 ai_analyze_sentiment, ai_extract, ai_summarize를 적용한다. 감정·상품명·지역·불만 사항·요약을 테이블에 저장하고 SQL로 조회한다.
목차
활용 2편에서는 AI가 SQL과 대시보드를 만들었다. 이번에는 SQL 안에서 AI 함수를 호출해 리뷰 문장을 분석한다. 한 문장에 섞여 있는 감정·상품·지역·불만을 컬럼으로 나누고, 긴 리뷰는 짧게 요약한다.
기존 판매·택시 테이블은 사용하지 않는다. 가상 고객 리뷰 6개를 새로 만들고, Notebook 하나에서 셀을 위에서 아래로 실행한다.
| 함수 | 입력 | 이번에 얻을 결과 |
|---|---|---|
ai_analyze_sentiment | 리뷰 문장 | 긍정·부정·중립·혼합 감정 |
ai_extract | 리뷰 문장과 추출할 항목 | 상품명·도시·불만 사항 |
ai_summarize | 리뷰 문장과 목표 길이 | 짧은 요약 |
AI Functions는 Databricks의 내장 SQL 함수다. 이 실습의 세 함수는 모델을 직접 배포하거나 별도 API 호출 코드를 작성하지 않고 사용한다. AI Functions
실습 화면은 2026년 10월 16일 Databricks Free Edition의 Serverless Notebook에서 촬영했다. 설명은 같은 날짜의 Databricks on AWS 공식 문서를 기준으로 작성했다. ai_analyze_sentiment와 ai_summarize는 Public Preview이며 영어에 맞춰 조정되어 있으므로 입력 리뷰는 영어, 설명은 한국어로 진행한다. AI 결과의 표현은 실행마다 달라질 수 있다. 감정 분석, 요약
1. Notebook과 리뷰 데이터 준비하기
Databricks Free Edition의 Workspace에 review_ai_lab 폴더를 만들고 Python Notebook 01_review_ai 를 추가한다. Compute는 Serverless로 선택한다.
이후 코드는 모두 이 Notebook의 SQL 셀에서 실행한다. Python Notebook에서 SQL을 실행하므로 각 코드의 첫 줄 %sql을 그대로 넣는다. 함수 사용 가능 여부는 workspace의 지원 지역과 권한에 따라 다르며, Classic SQL warehouse에서는 지원되지 않는다. 실행 조건
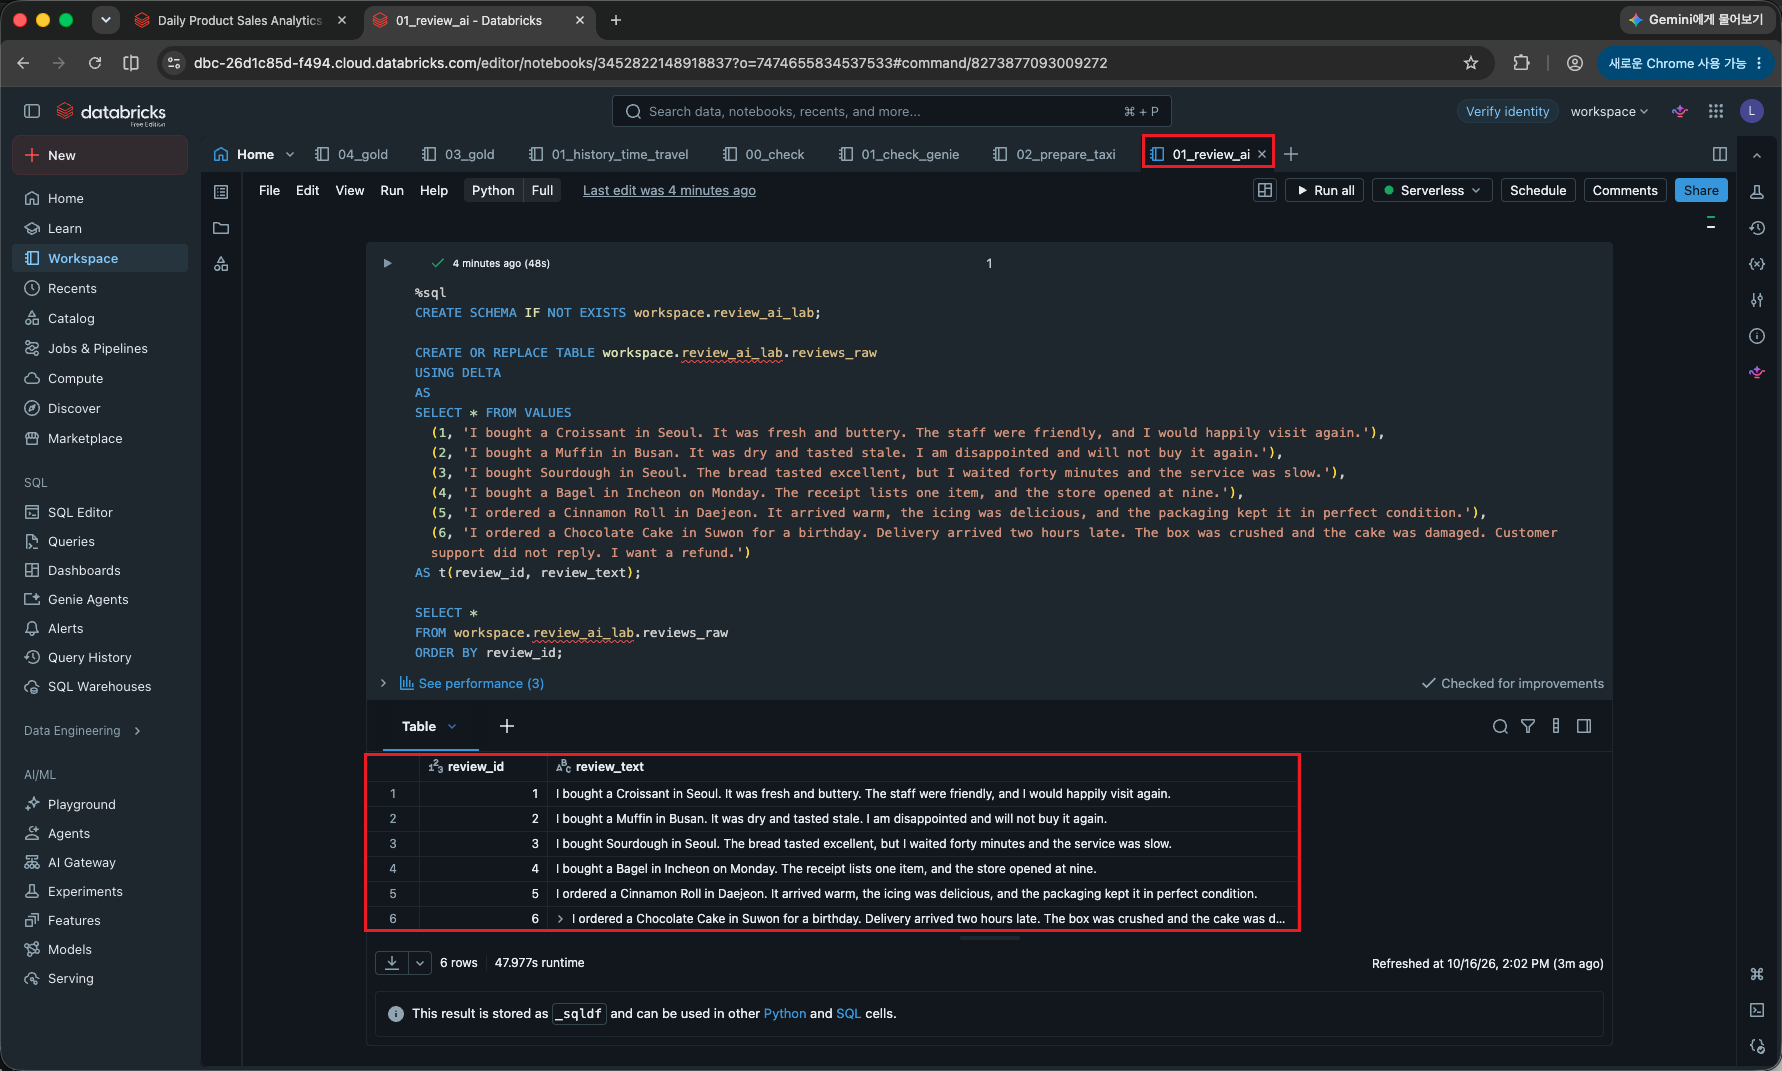
첫 셀에 아래 코드를 넣고 실행한다.
| |
6행이 생성된다. 입력 내용은 다음과 같다.
| ID | 상품·도시 | 리뷰의 뜻 |
|---|---|---|
| 1 | Croissant·Seoul | 신선하고 맛있으며 직원도 친절함 |
| 2 | Muffin·Busan | 퍽퍽하고 오래된 맛이라 실망함 |
| 3 | Sourdough·Seoul | 맛은 좋지만 40분 대기와 느린 서비스가 불만 |
| 4 | Bagel·Incheon | 구매일·영수증·개점 시각만 언급 |
| 5 | Cinnamon Roll·Daejeon | 따뜻하고 맛있으며 포장 상태도 좋음 |
| 6 | Chocolate Cake·Suwon | 배송 지연·상자와 케이크 파손·응답 지연으로 환불 요청 |
2. 리뷰의 감정 분류하기
새 SQL 셀에서 실행한다. 리뷰별 감정을 분석해 별도 테이블에 저장한다.
| |
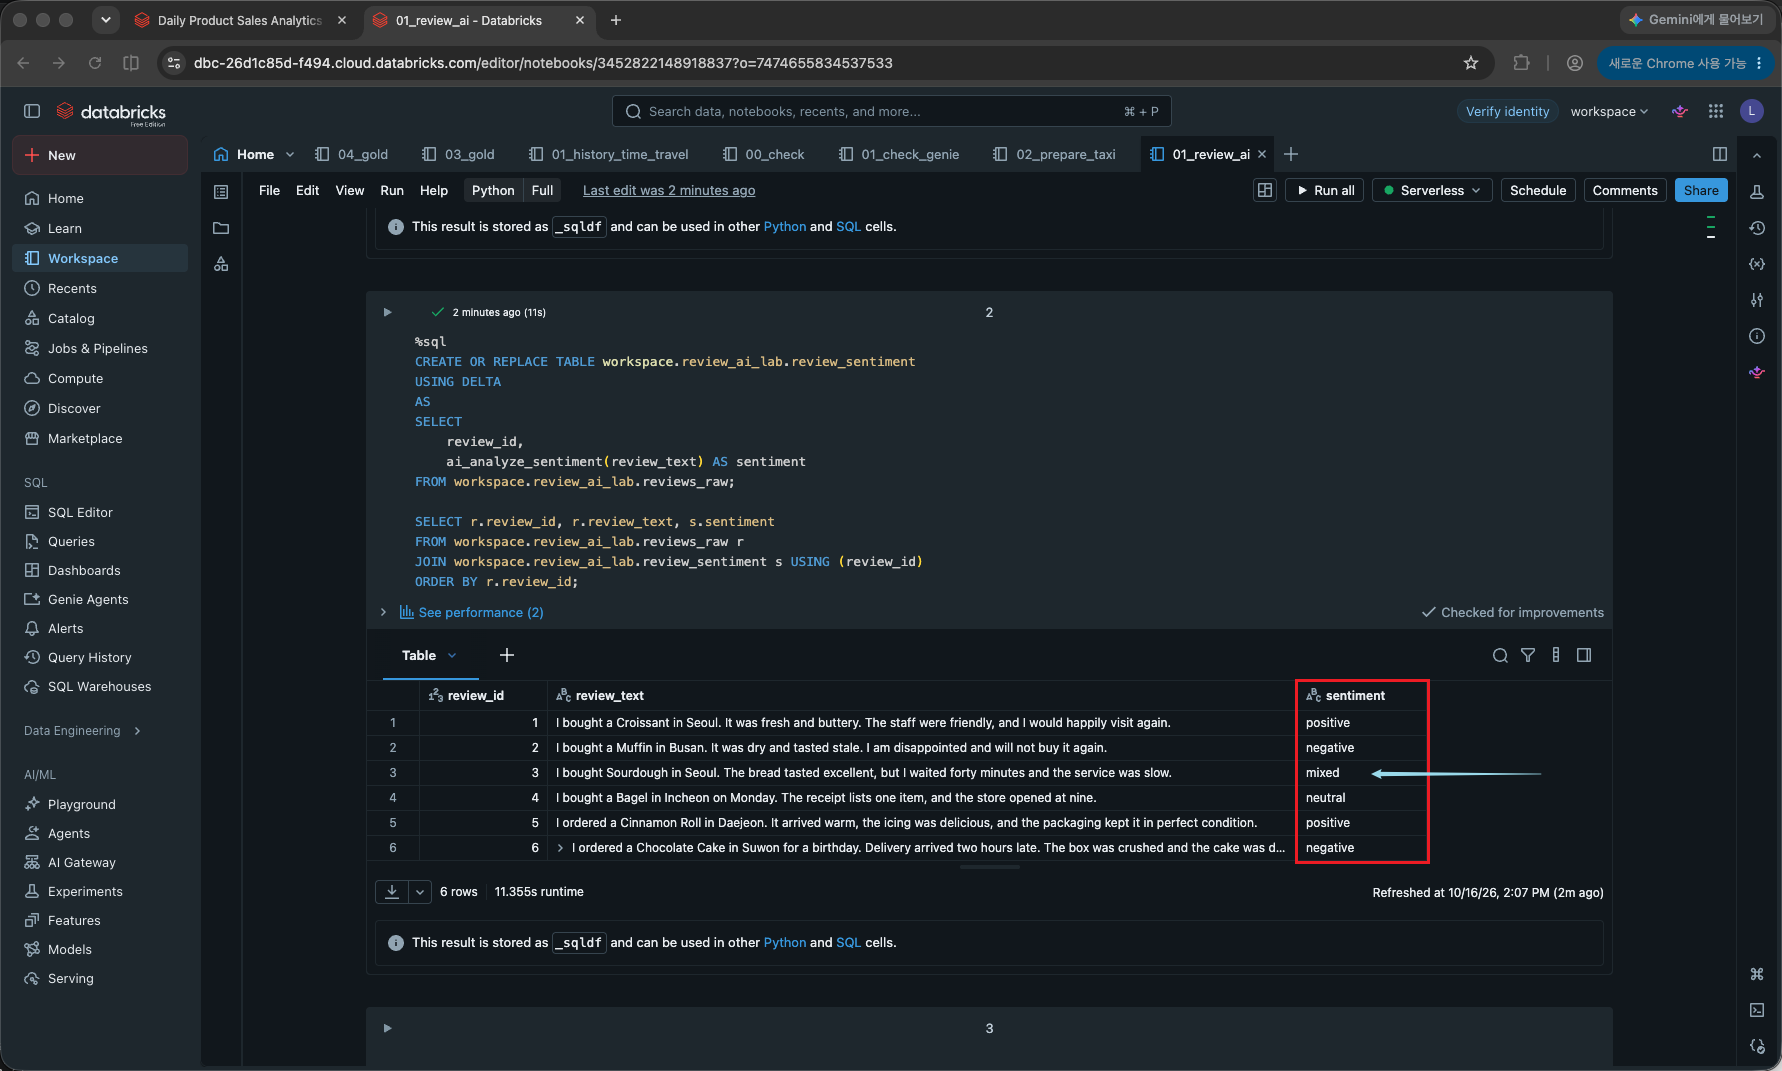
sentiment는 positive, negative, neutral, mixed 중 하나이며 감정을 판단하지 못하면 NULL이 나올 수 있다. 반환값
실습에서는 1·5번은 positive, 2·6번은 negative, 3번은 mixed, 4번은 neutral로 분류됐다. 입력의 의미와 맞는 결과였다. 다만 모델의 분류를 SQL 계산처럼 항상 같은 값이 나오는 정답으로 취급하지는 않는다.
특히 3번은 맛에 대한 칭찬과 서비스 불만이 함께 있다. 단순히 부정 단어가 있는지 찾는 방식과 문맥을 분류하는 방식의 차이를 볼 수 있는 예다.
3. 상품·도시·불만 사항 추출하기
이번에는 리뷰에서 필요한 정보를 꺼낸다. 새 SQL 셀에서 아래 코드를 실행한다.
| |
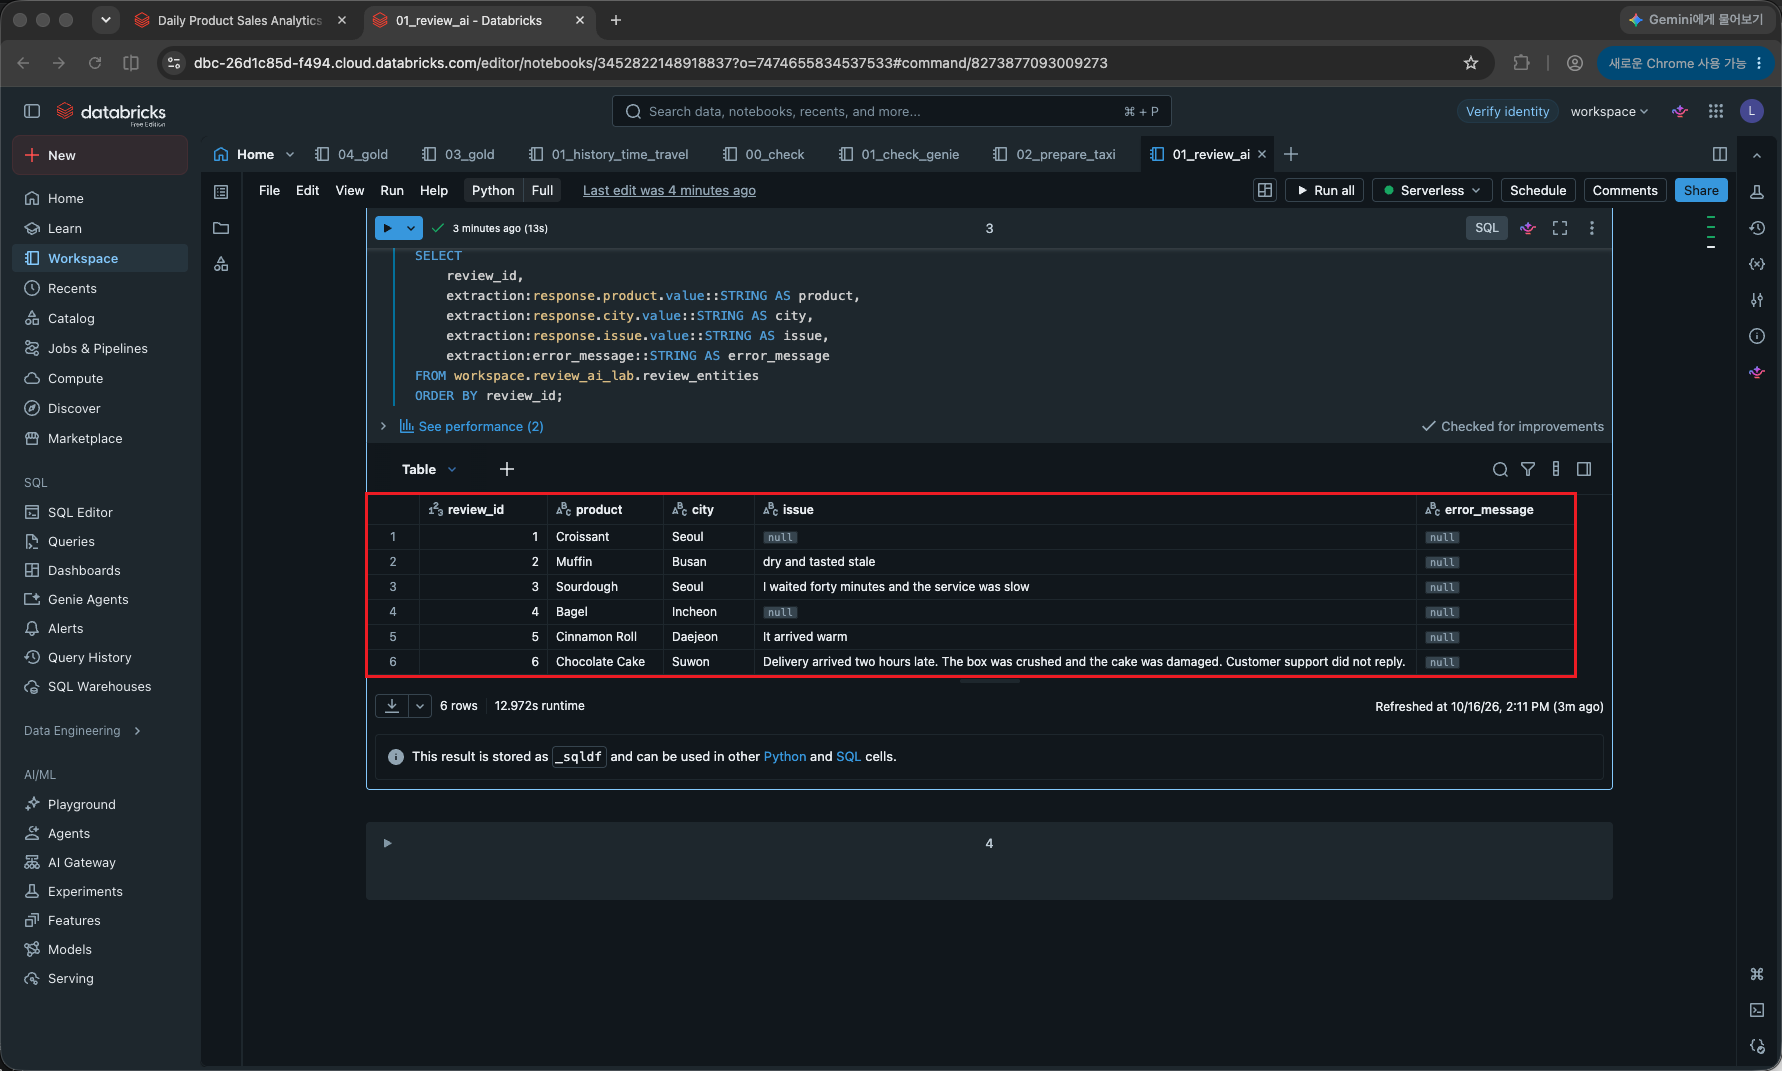
ai_extract에는 어떤 항목을 꺼낼지와 각 항목의 의미를 전달한다. 이번 코드는 버전을 2.1로 지정했다. 이 버전은 VARIANT를 반환하며, 추출값은 response 안의 각 필드의 value에 있다. 예를 들어 extraction:response.product.value::STRING은 상품명을 문자열로 꺼내는 식이다. 추출 스키마와 반환 구조
상품명과 도시는 1절의 표와 비교한다. issue는 2번의 오래된 맛, 3번의 대기·서비스, 6번의 배송·파손·응대 문제를 담는지 본다. 불만을 쓰지 않은 리뷰는 NULL이 자연스럽다. 원문에 없는 불만이 생성됐다면 올바른 추출로 보지 않는다.
실제 결과에서 상품과 도시는 원문대로 추출됐고, 1·4번의 issue는 NULL이었다. 하지만 5번에는 긍정적인 표현인 It arrived warm이 불만 사항으로 잘못 들어갔다.
error_message는 6행 모두 NULL이었다. 이 컬럼은 함수 처리 오류를 나타내며, NULL이라고 내용까지 정확하다는 뜻은 아니다. 원문과 대조해야 이런 의미 오류를 찾을 수 있다.
4. 긴 리뷰를 짧게 요약하기
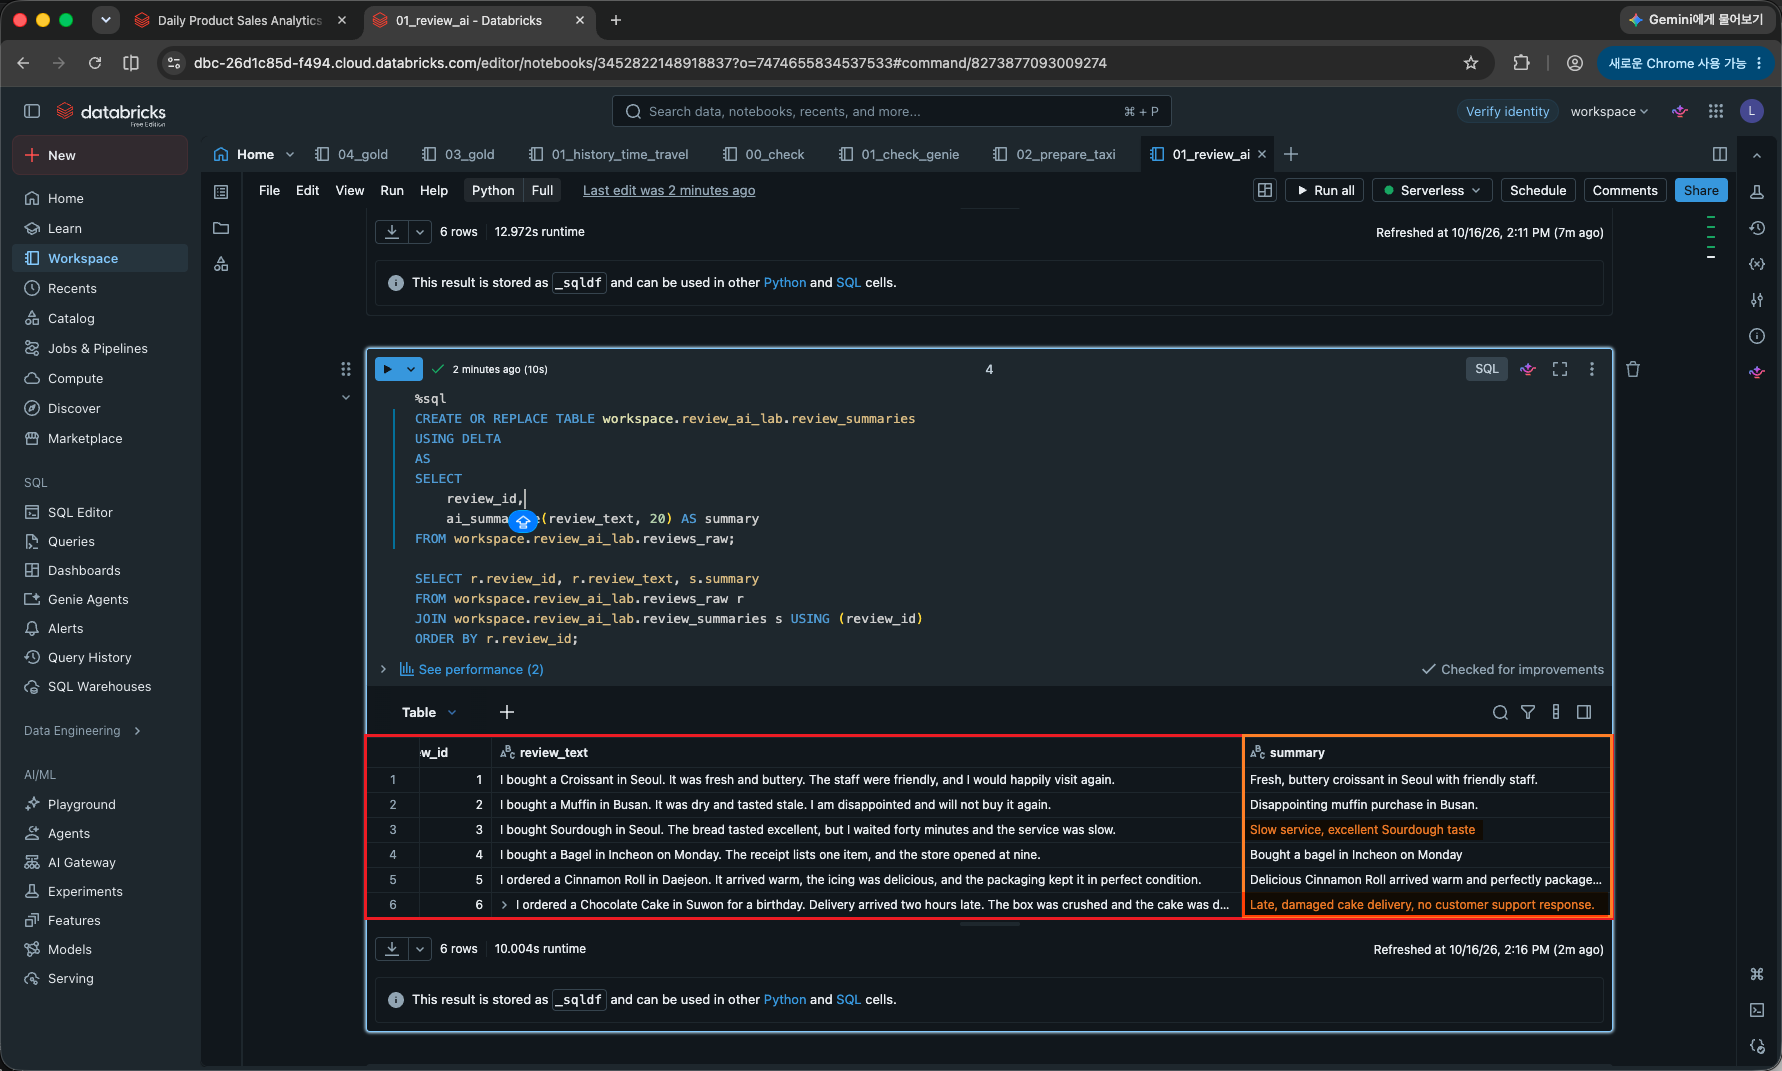
새 SQL 셀에서 실행한다. 리뷰별 요약을 저장한다.
| |
두 번째 인자 20은 약 20단어를 목표로 요약하라는 값이다. 정확히 20단어로 자르는 규칙은 아니다. 요약 문장도 고정되지 않는다. 요약 길이
3번은 Slow service, excellent Sourdough taste로 요약돼 맛에 대한 칭찬과 서비스 불만이 함께 남았다.
6번은 Late, damaged cake delivery, no customer support response.로 요약됐다. 배송 지연·파손·고객 지원 문제는 남았지만 환불 요청은 빠졌다. 짧은 요약만 읽으면 고객이 원하는 조치를 놓칠 수 있다.
5. 분석 결과를 한 테이블로 모으기
감정·추출 정보·요약을 리뷰 ID로 연결한다. 새 SQL 셀에서 실행한다.
| |
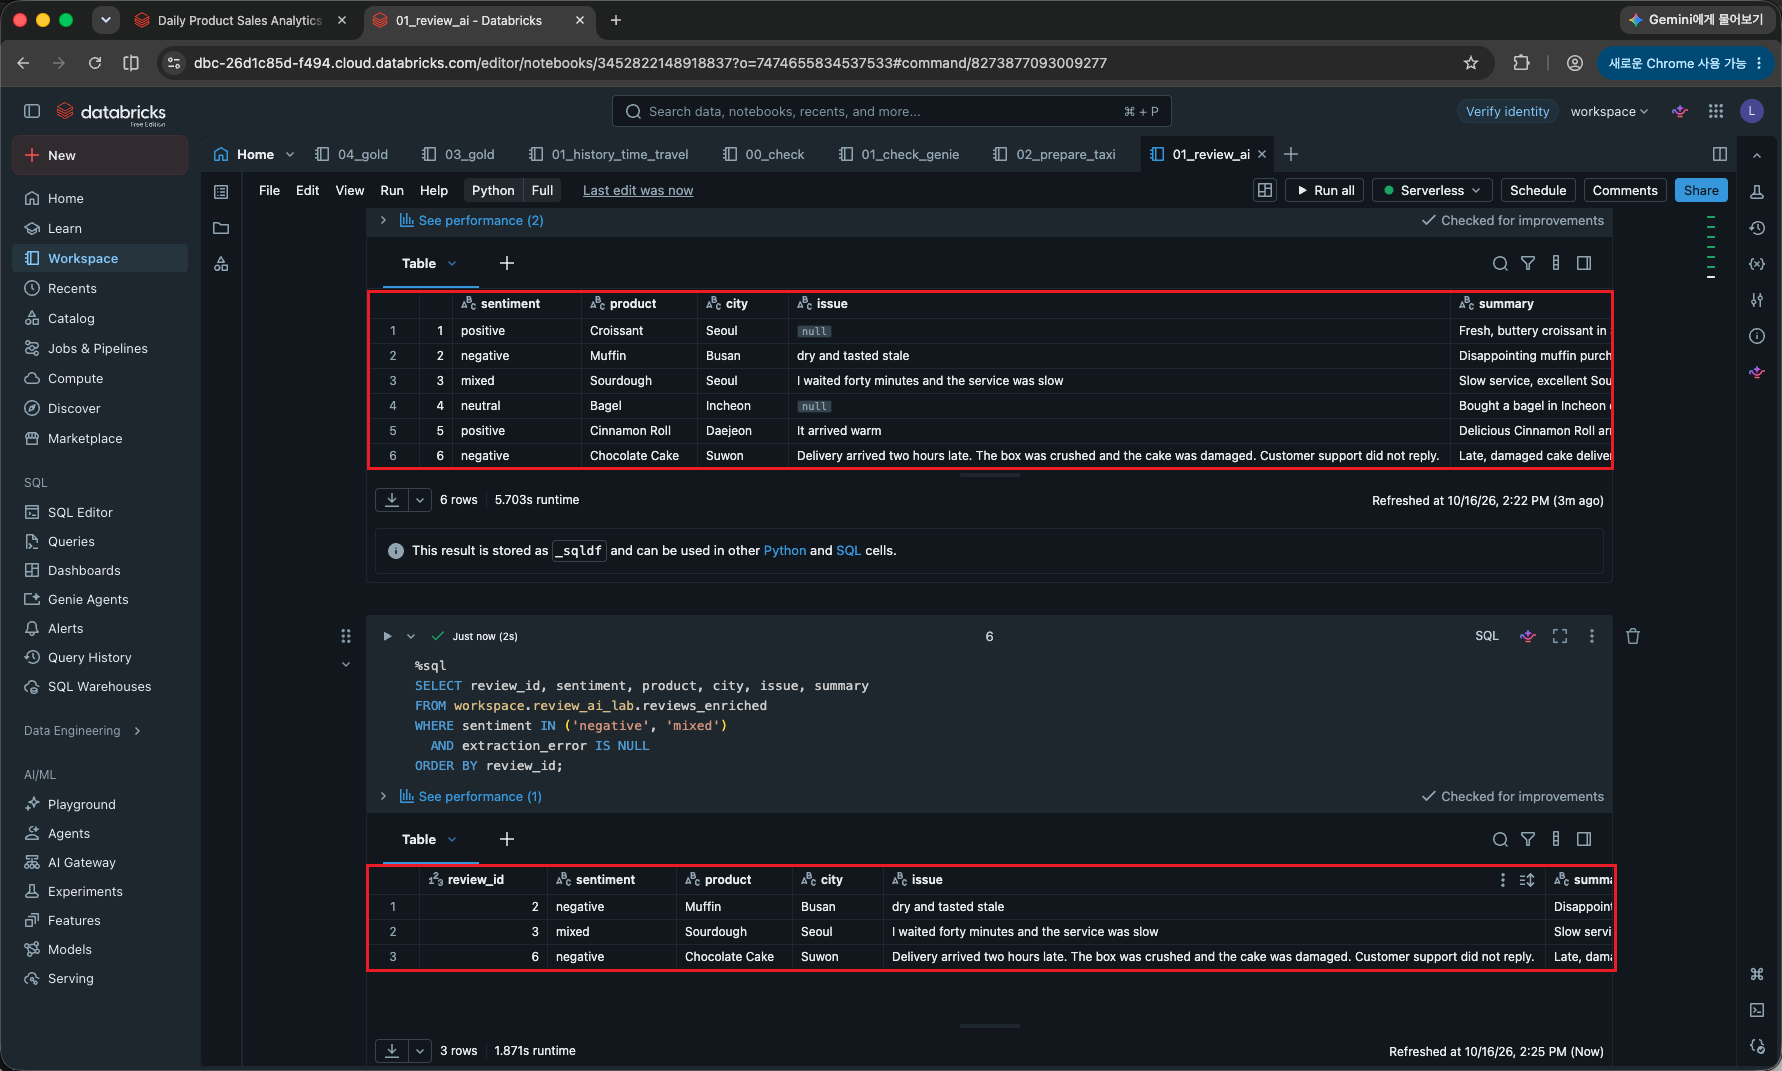
이제 문장으로만 있던 리뷰가 감정·상품·도시·불만·요약 컬럼을 가진 6행이 된다. 이후에는 일반 SQL로 이 컬럼을 조회할 수 있다.
같은 Notebook의 마지막 SQL 셀에서 부정·혼합 감정으로 분류된 리뷰를 조회한다. 이 셀은 저장된 결과만 읽는다.
| |
실제 조회 결과는 2번 Muffin, 3번 Sourdough, 6번 Chocolate Cake의 3행이었다. 부정 또는 혼합 감정으로 분류된 리뷰만 남았다.
이 결과는 불만 검토 후보다. 앞서 본 5번의 잘못된 불만 추출과 6번 요약의 환불 요청 누락처럼, 함수가 실행됐더라도 내용에는 오류나 누락이 있을 수 있다. 검토할 때는 원문을 함께 읽는다.
결과를 저장한 이유
2~4절은 AI 함수를 호출하고 결과 테이블을 만든다. 이 셀을 다시 실행하면 AI 분석도 다시 수행한다. 반면 5절의 결과 결합과 조회는 저장된 값만 사용하므로 모델을 다시 호출하지 않는다. 함수 실행에는 연산과 모델 추론 사용량이 발생할 수 있다. 실행과 사용량
리뷰가 늘어나면 새 리뷰만 분석하고 기존 결과는 재사용하는 방식으로 확장할 수 있다. 이번에는 6개 리뷰를 대상으로 SQL에서 AI를 호출하고, 결과를 테이블로 남겨 조회하는 과정까지 진행한다.
시리즈
Databricks 활용
- [Databricks] Gold 테이블로 BI 판매 대시보드 만들기 - 활용 1편
- [Databricks] Genie로 데이터 질문하고 대시보드 만들기 - 활용 2편
- [Databricks] AI Functions로 고객 리뷰 분류·추출·요약하기 - 활용 3편 현재 글