Data Engineering
[Databricks] Delta Lake MERGE 실습: 신규·정정 데이터 반영하기 - 4편
Bakehouse 판매 데이터에 신규·정정 내역을 MERGE로 반영하고, 같은 입력을 다시 처리해도 중복되지 않는지 확인한다. Silver 검증과 Gold 재집계를 Jobs로 연결한다.
목차
3편에서는 Bronze·Silver·검사·Gold 작업을 Jobs로 연결했다. 실행은 자동화했지만, 데이터는 매번 표본 전체를 읽어 교체했다. 새 판매 내역이 들어오거나 기존 금액이 정정되면 어떻게 반영해야 할까?
이번에는 Delta Lake의 MERGE로 기존 행은 수정하고 새 행은 추가한다. 같은 변경 데이터를 두 번 처리해 행이 중복되지 않는지 확인하고, 정정된 결과를 Gold 집계에도 반영한다.
실습 화면은 2026년 10월 12일 Databricks Free Edition의 Serverless Notebook 환경에서 촬영했다. SQL과 Jobs 동작은 같은 날짜의 Databricks on AWS 공식 문서를 기준으로 설명한다.
전체 교체에서 변경 반영으로
판매 내역 하나의 금액이 잘못됐다고 하자. 테이블을 매번 전체 교체하면 수정된 원천 전체를 다시 읽어야 한다. 그렇다고 변경 내역을 단순히 추가하면 기존 행과 정정 행이 함께 남아 매출이 중복될 수 있다.
MERGE는 입력과 대상의 어떤 행이 같은 내역인지 조건으로 비교한다. 이번에는 transaction_id가 같으면 같은 판매 내역이라고 정하고, 입력에 들어 있는 최신 값으로 바꾼다. 대상에 없는 식별자는 새 행으로 넣는다. 기존 행 수정과 새 행 추가를 함께 처리하는 방식을 upsert라고 부른다. Delta Lake MERGE
| 입력과 대상의 관계 | SQL 절 | 이번 처리 |
|---|---|---|
| 같은 거래 식별자가 있음 | WHEN MATCHED | 입력의 값으로 수정 |
| 같은 거래 식별자가 없음 | WHEN NOT MATCHED | 새 판매 내역 추가 |
| 대상에만 있고 이번 입력에는 없음 | 별도 절을 두지 않음 | 기존 내역 유지 |
이번 입력은 전체 판매 내역이 아니라 변경분이다. 입력에 없는 행을 삭제하면 나머지 판매 내역까지 지워질 수 있으므로 삭제 처리는 넣지 않는다.
1. 별도 schema에 기준 데이터 만들기
Workspace에 bakehouse_merge_lab 폴더를 만들고 00_prepare Notebook을 만든다. 기본 언어는 Python, 실행 환경은 Serverless로 선택한다. SQL 셀은 %sql, Python 셀은 %python으로 시작한다.
결과는 **workspace.bakehouse_merge_lab**에 저장한다. 2·3편의 workspace.bakehouse_lab과 경로가 다르므로 기존 스케줄이 이 실습 결과를 덮어쓰지 않는다. 다른 catalog를 쓰고 있다면 아래 코드의 workspace를 쓰기 권한이 있는 이름으로 모두 바꾼다.
| 테이블 | 역할 |
|---|---|
seed_sales_transactions | 변경 전 기준 데이터. 비교할 때 계속 유지 |
bronze_sales_changes | 이번에 받은 변경 입력 두 행 |
silver_sales_transactions | MERGE로 갱신할 판매 상세 |
silver_after_first_merge | 첫 반영 결과를 보관한 재실행 비교용 테이블 |
gold_daily_product_sales | 날짜·매장·상품별 집계 |
먼저 Bakehouse 원천에서 최대 1,000행을 선택하고 2편의 Silver와 같은 형태로 정리한다.
| |
seed는 이후 비교를 위한 고정 기준점이다. 거래 식별자가 표본에서 유일한지 먼저 검사한다. 한 거래에 여러 상품 행이 있다면 거래 식별자만으로는 충분한 키가 아니다. 실제 데이터에서는 원천의 행 단위를 확인하고 상품 행 식별자 등으로 키를 바꿔야 한다.
다음 Python 셀로 기준 데이터의 필수 값과 중복을 확인한다.
| |
금액 합계는 변환을 검산하기 위한 값으로 사용한다. 2편과 마찬가지로 매장별 통화를 확인하지 않았으므로 회사 전체 매출 지표로 해석하지 않는다.
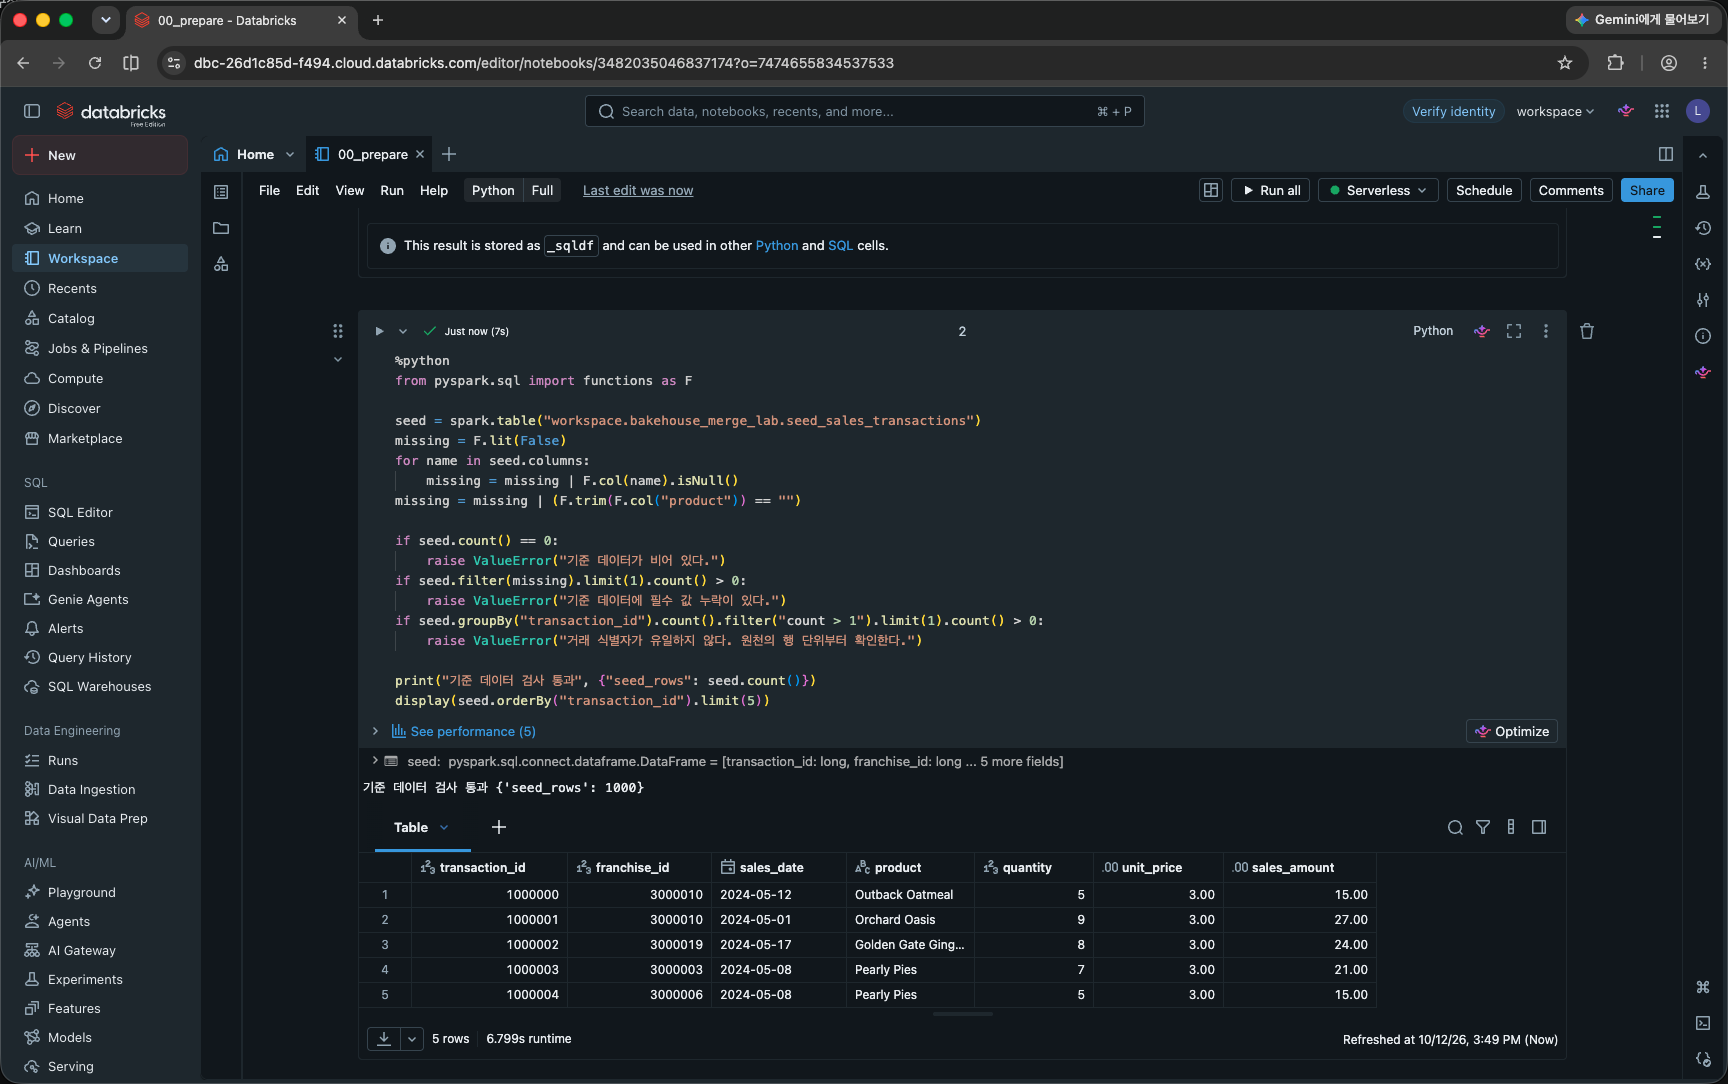
실습에서는 seed_rows가 1,000으로 출력됐고 기준 데이터 검사를 통과했다. 첫 거래 식별자는 1000000이며, 수량 5·단가 3.00·판매 금액 15.00이다.
1·2절은 실습 준비 단계다. 재실행 비교나 Jobs 실행에는 포함하지 않는다. 1절을 다시 실행하면 Silver가 초기 상태로 돌아가고 원천 표본도 바뀔 수 있다. 이후 00_prepare에 확인용 셀을 추가하더라도 Run all 대신 그 셀만 실행한다. 처음부터 다시 실습할 때만 1절부터 순서대로 진행한다.
2. 정정 한 행과 신규 한 행 준비하기
실제 원천이 바뀌기를 기다리지 않고, 기준 데이터로 가상의 변경 입력 두 행을 만든다.
- 가장 작은 거래 식별자의 판매 금액을 원래 값보다
5.00높인다. 수량과 단가는 그대로 두고 금액만 정정하는 예시다. - 기준 데이터의 최대 거래 식별자보다 1 큰 식별자로 새 내역을 만든다. 수량은 2, 단가는 10.00, 금액은 20.00으로 지정한다.
새 내역의 날짜·매장·상품은 첫 행에서 가져온다. 이 식별자 생성 규칙은 고정 표본에서 충돌 없이 실습하기 위한 것이며, 운영의 거래 식별자 발급 방식이 아니다.
| |
bronze_sales_changes는 이번에 받은 입력을 고정해 보관하는 테이블이다. 변환 전에 금액·날짜 형식이 정리된 입력을 받았다고 가정한다. 원본 파일 수집과 자료형 변환은 앞 편의 내용과 겹치므로 이 실습에서는 변경 반영에 집중한다.
Silver에서 현재 값을 가져와 5를 더하지 않고, 변하지 않는 seed에서 정정 값을 만든다. 입력 생성 단계부터 같은 자료로 같은 값을 만들도록 한 것이다.
두 행을 대상과 비교한다.
| |
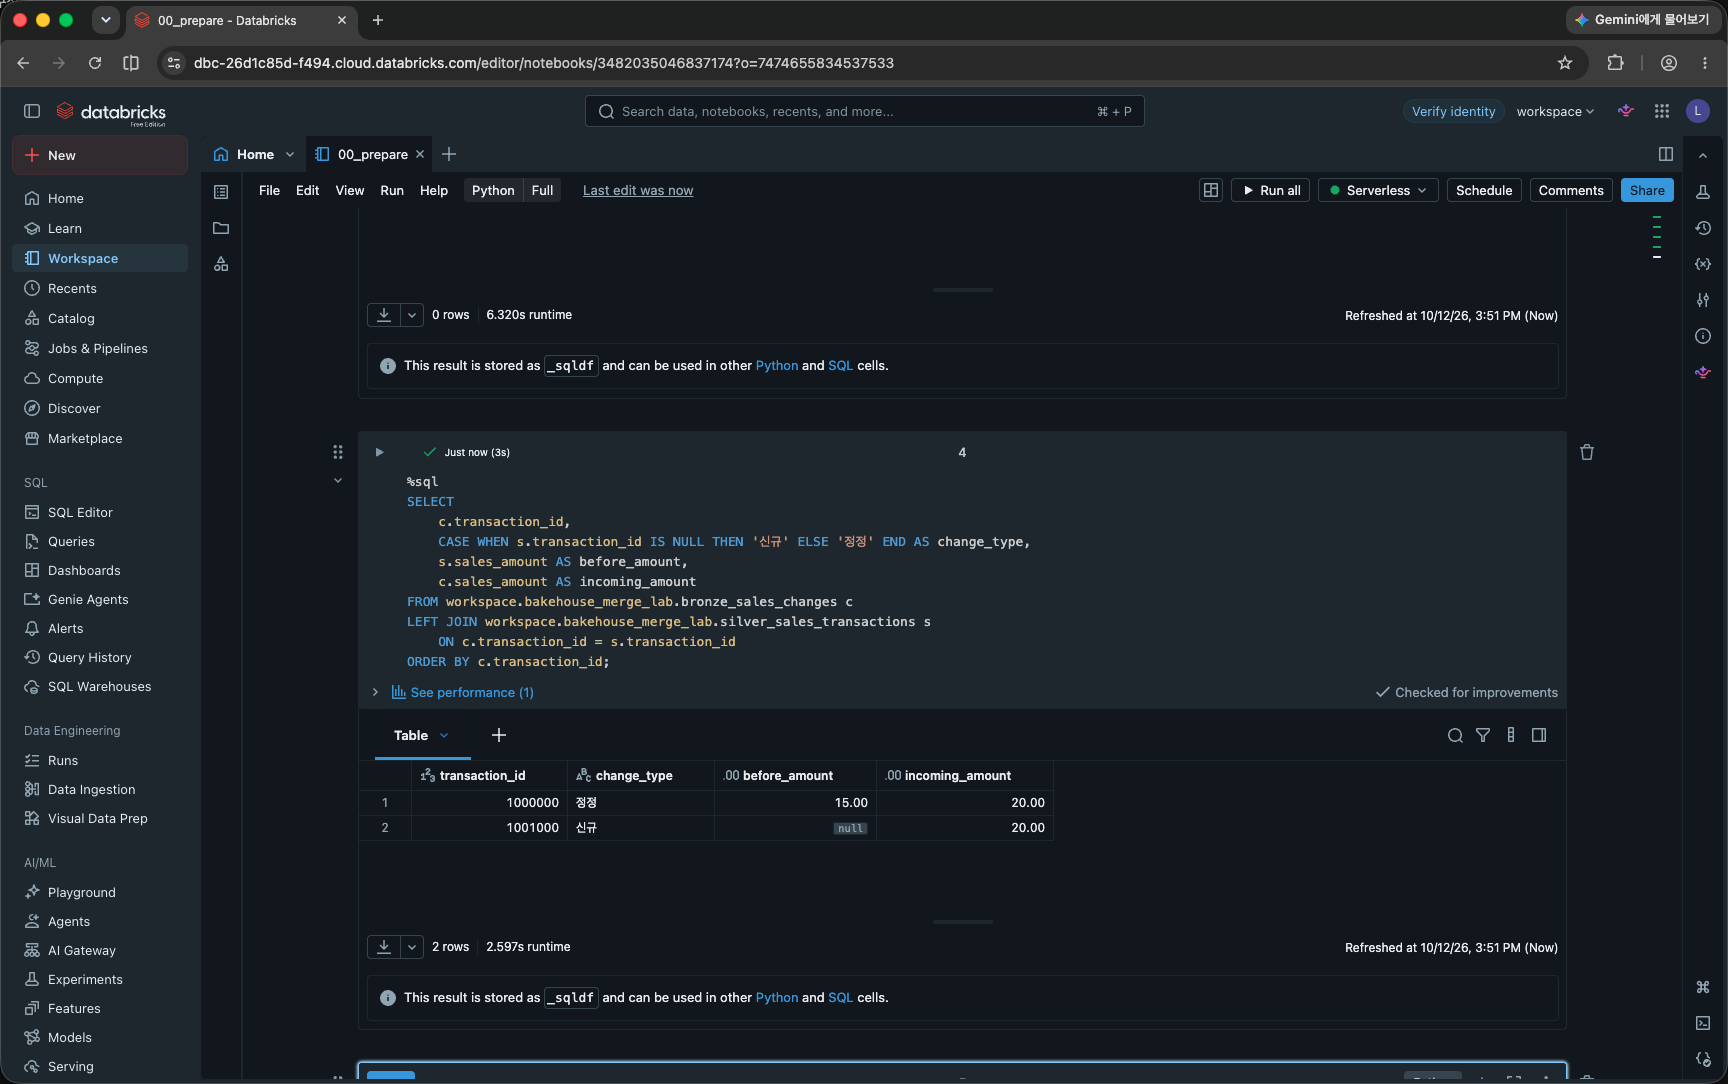
처음 반영하기 전에는 정정 행 하나와 신규 행 하나가 보여야 한다. 정정 행의 두 금액 차이는 5.00, 신규 행의 before_amount는 NULL이다. 반영 후 다시 조회하면 신규 행도 대상에 존재하므로 이 쿼리는 두 행 모두 ‘정정’으로 표시한다.
실제 조회에서는 거래 1000000의 기존 금액이 15.00, 정정할 입력 금액이 20.00으로 표시됐다. 거래 1001000은 기존 금액이 NULL인 신규 내역이고, 입력 금액은 20.00이었다.
3. 입력을 검사하고 MERGE 실행하기
작업을 나중에 Jobs로 옮기기 쉽도록 같은 폴더에 Notebook 네 개를 추가한다.
| Notebook | 실행할 내용 |
|---|---|
01_validate_changes | 변경 입력과 대상 키 검사 |
02_merge_silver | MERGE 한 문장 실행 |
03_validate_silver | 반영된 Silver를 기대 데이터와 대조 |
04_gold | Gold 전체 재집계와 합계 검산 |
각 Notebook은 테이블을 다시 읽는다. 다른 Notebook에서 만든 Python 변수나 임시 뷰를 이어받는 구성은 사용하지 않는다.
변경 입력의 중복부터 확인하기
01_validate_changes의 Python 셀에 다음 코드를 넣고 실행한다.
| |
입력 여러 행이 같은 대상 행을 수정하려 하면 어떤 값을 쓸지 모호해져 MERGE가 실패할 수 있다. 대상에 아직 없는 키도 입력 안에서 중복되면 여러 행이 삽입될 수 있으므로, MERGE를 사용한다고 입력 내부 중복이 자동으로 없어지는 것은 아니다. 입력 중복과 MERGE
중복 판정에는 Runtime별 차이도 있지만, 여기서는 버전에 기대지 않고 입력과 대상 모두 키가 유일한지 검사한다. 중복이 나오면 임의의 한 행을 남기지 말고 원천의 키와 정정 순서를 먼저 확인한다.
기존 값에 더하지 않고 입력 값으로 교체하기
02_merge_silver에 다음 SQL 셀을 넣는다. 앞 Notebook의 검사를 통과한 뒤 실행한다.
| |
t는 갱신 대상, s는 변경 입력이다. ON에서 같은 내역인지 판단하고, 일치하면 필요한 컬럼을 입력 값으로 바꾼다. 일치하지 않으면 입력의 일곱 컬럼으로 새 행을 만든다. MERGE INTO 문법
중요한 부분은 sales_amount = s.sales_amount다. 정정 후 금액을 그대로 저장하므로 같은 입력을 다시 받아도 값이 또 증가하지 않는다. sales_amount = t.sales_amount + 5처럼 현재 대상 값에 누적하면 재실행할 때마다 5가 더해진다.
이번 입력은 각 거래의 정정 후 전체 값이다. ‘금액에 5를 더하라’는 증감 이벤트를 그대로 받는 파이프라인이라면 이벤트 식별자와 중복 처리 기준을 별도로 설계해야 한다.
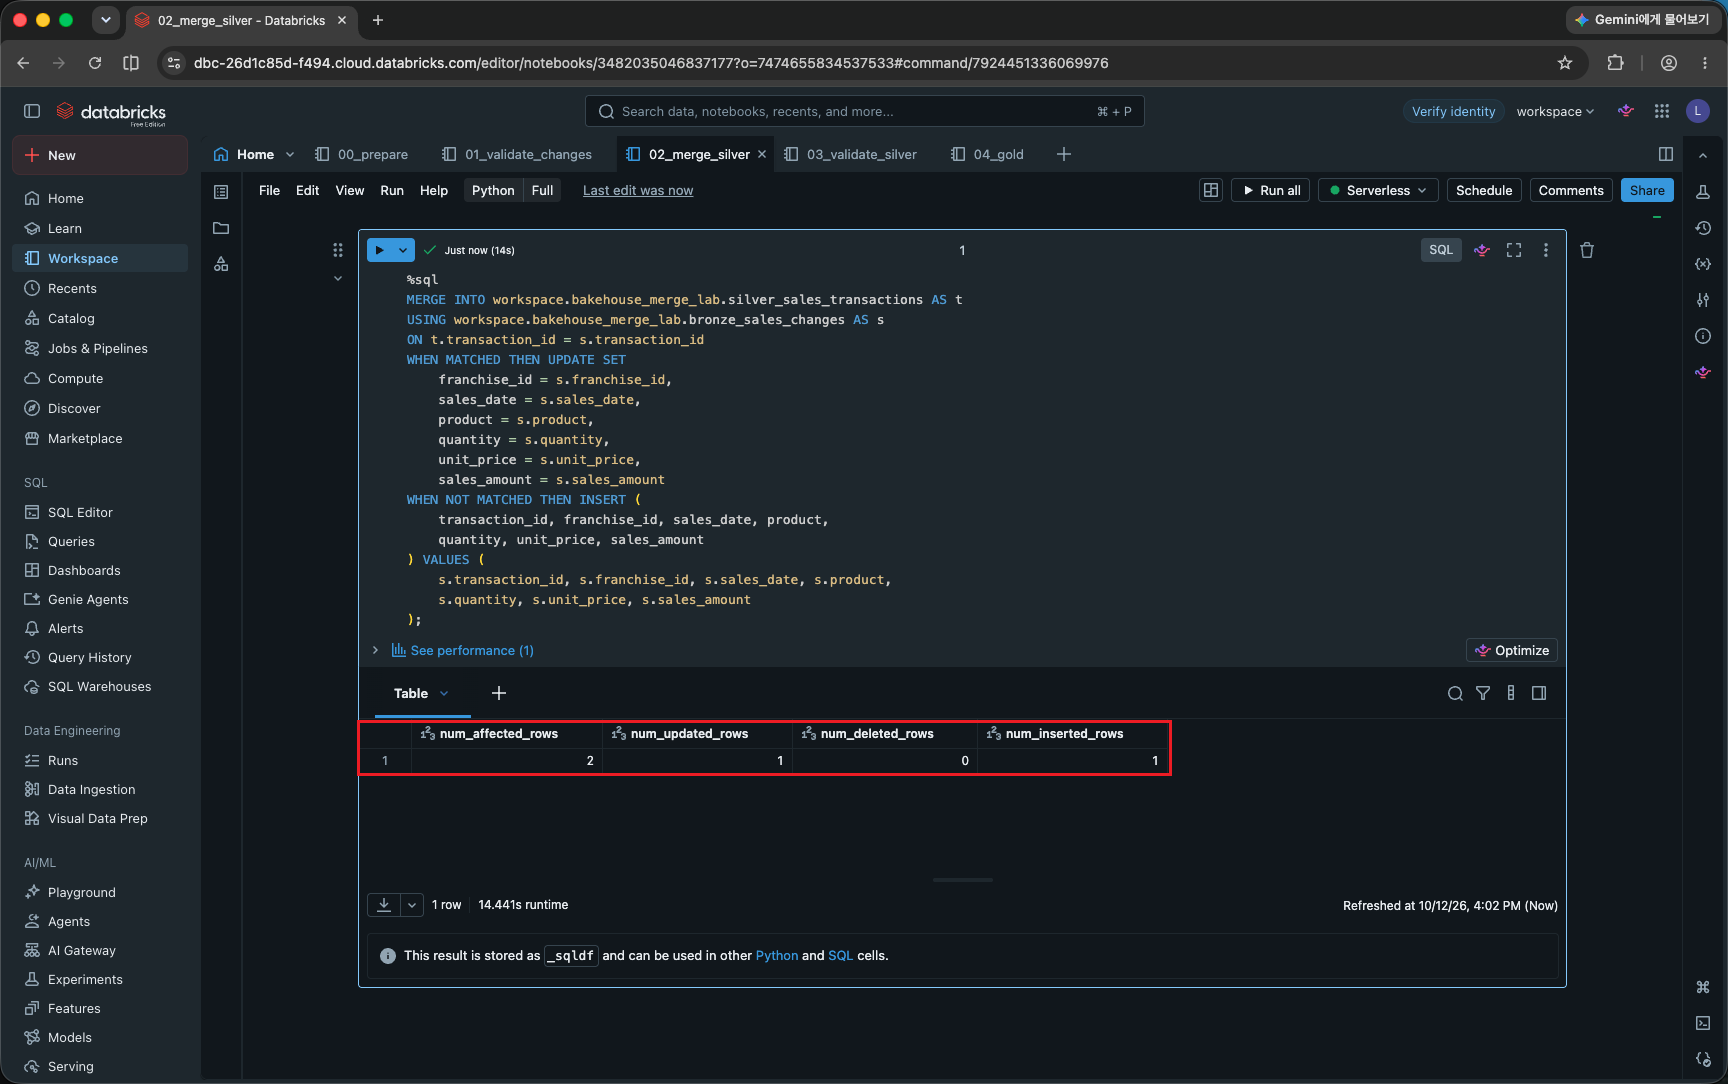
첫 MERGE의 출력은 num_updated_rows = 1, num_inserted_rows = 1, num_deleted_rows = 0이다. 기존 판매 내역 한 행을 수정하고 신규 내역 한 행을 추가했다.
4. 반영 결과와 재실행 결과 확인하기
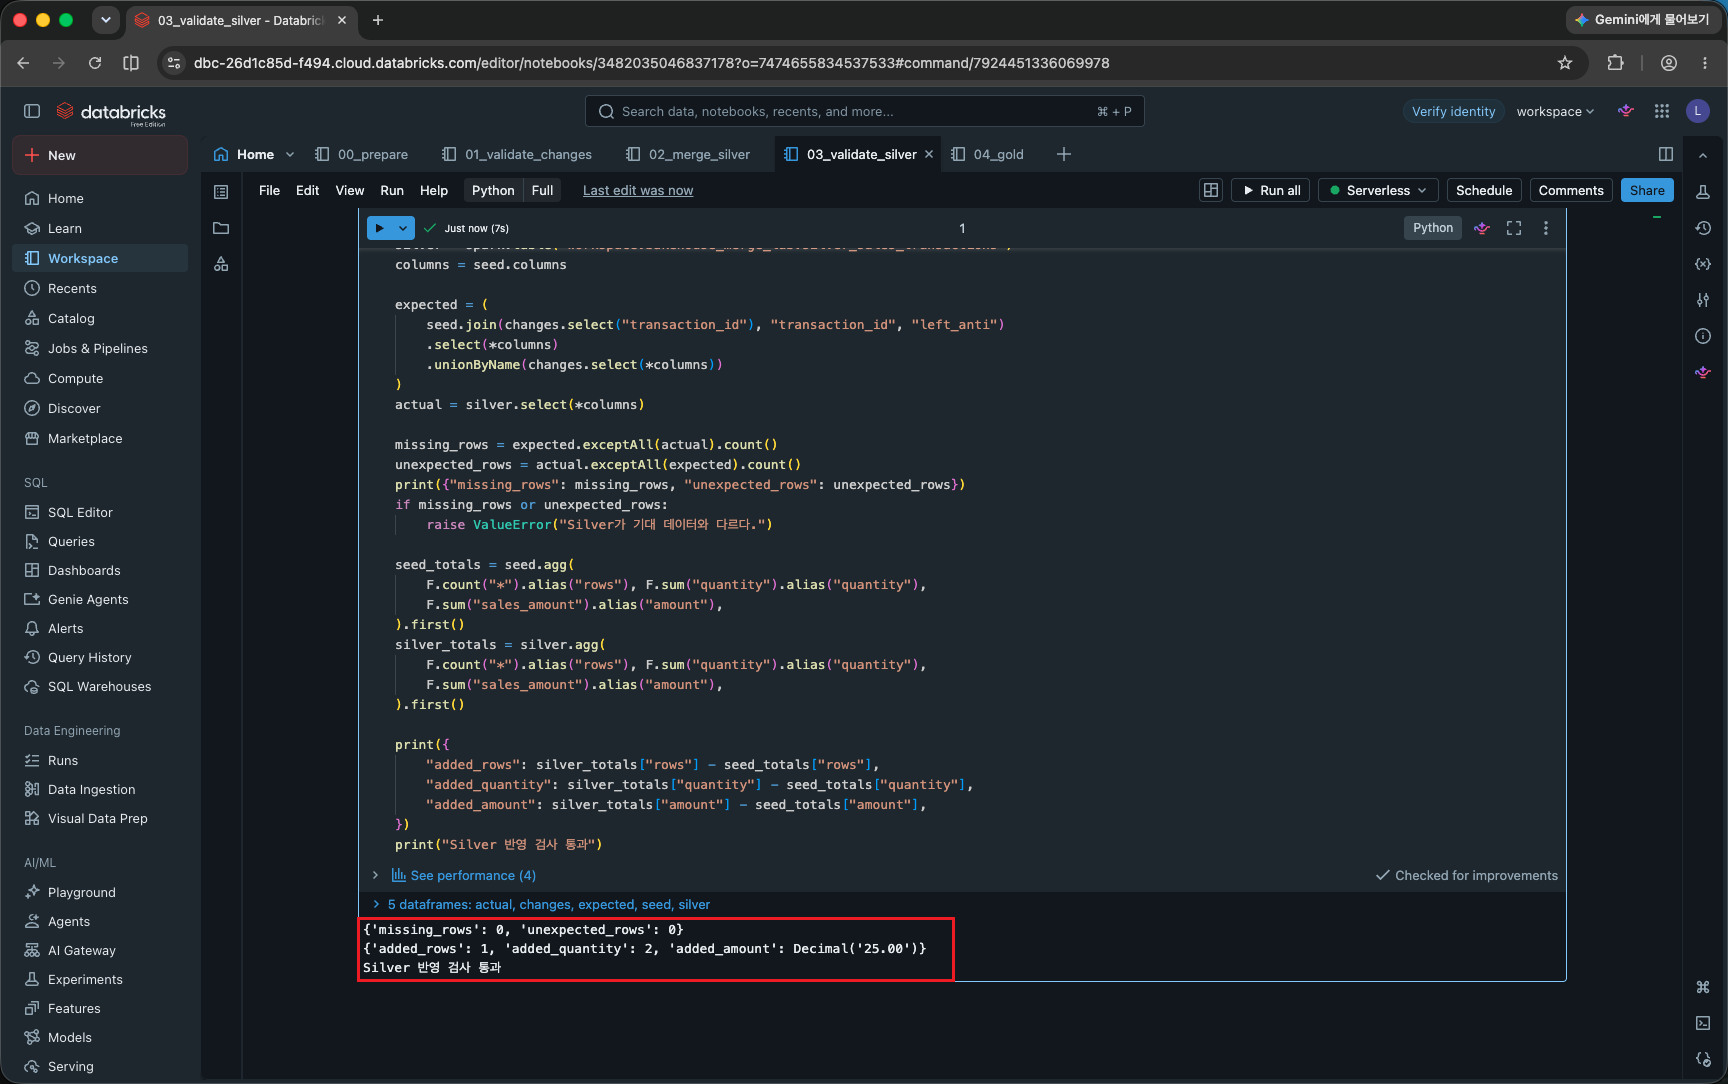
03_validate_silver에는 아래 Python 셀을 넣는다. 기대 데이터는 변경 입력에 없는 기존 행 + 변경 입력 두 행이다. 합계만 비교하면 서로 다른 행의 오류가 상쇄될 수 있으므로 전체 일곱 컬럼을 대조한다.
| |
exceptAll()은 한쪽에만 남는 행을 찾으며 같은 값의 행이 반복된 횟수도 보존한다. 양방향 차이가 모두 0이면 이 비교 시점의 데이터가 일치한다. 비교 컬럼은 양쪽에서 같은 순서로 선택했다. DataFrame.exceptAll
이 입력에서 기대하는 변화는 다음과 같다. 금액 증가는 정정분 5.00과 신규분 20.00의 합이다.
| 검사 값 | 기대 결과 |
|---|---|
missing_rows, unexpected_rows | 모두 0 |
added_rows | 1 |
added_quantity | 2 |
added_amount | 25.00 |
기준 데이터가 1,000행이면 Silver는 1,001행이다. 표본이 그보다 적었다면 실제 기준 행 수에 1을 더한 값으로 확인한다.
실행 결과는 양방향 차이가 모두 0이고, 증가분은 1행·수량 2·금액 25.00이었다. 금액은 Python 출력에서 Decimal('25.00')으로 표시됐다.
같은 입력을 한 번 더 반영하기
첫 반영이 맞는지 확인했으면 00_prepare의 새 SQL 셀에서 결과를 별도 테이블로 보관한다. 앞의 준비 셀을 다시 실행하지 않는다.
| |
이제 01_validate_changes → 02_merge_silver → 03_validate_silver 순서로 다시 실행한다. 변경 입력은 그대로 둔다. 두 번째 반영에서도 added_rows = 1, added_quantity = 2, added_amount = 25.00이어야 한다. 이 숫자는 첫 실행 대비가 아니라 초기 seed 대비다.
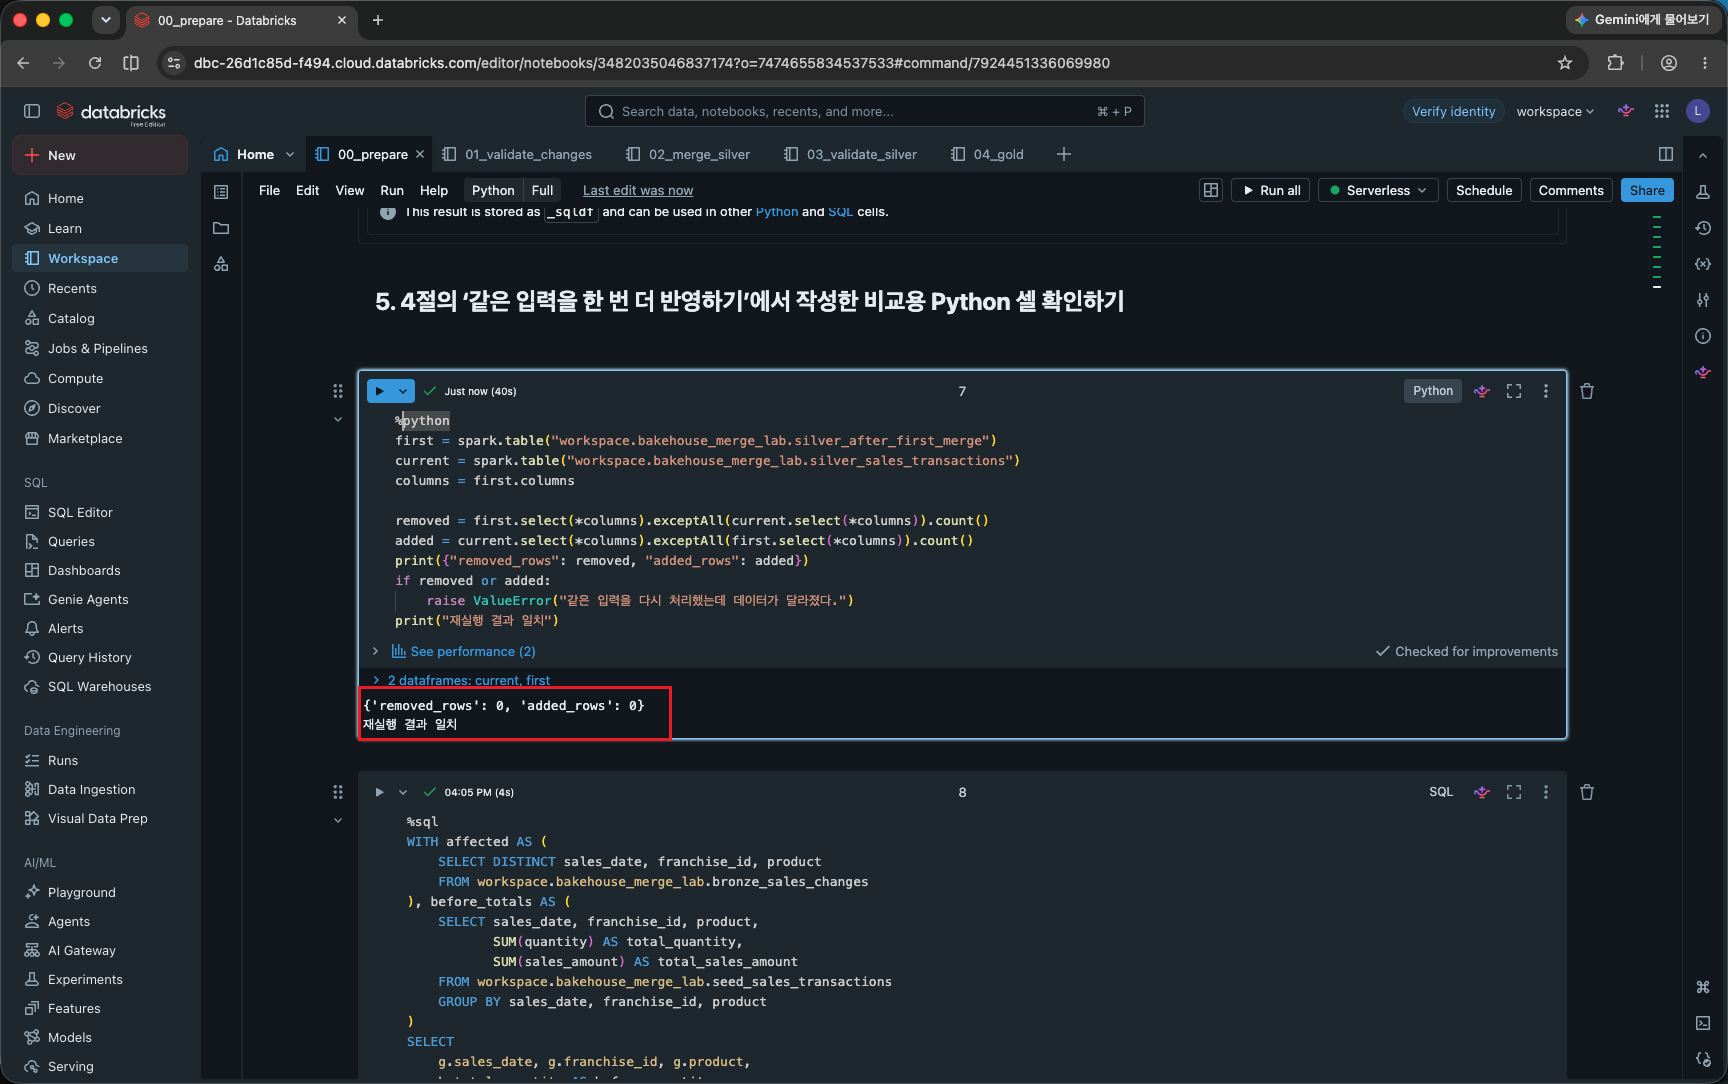
00_prepare의 새 Python 셀에서 첫 반영 결과와 현재 결과를 직접 비교한다.
| |
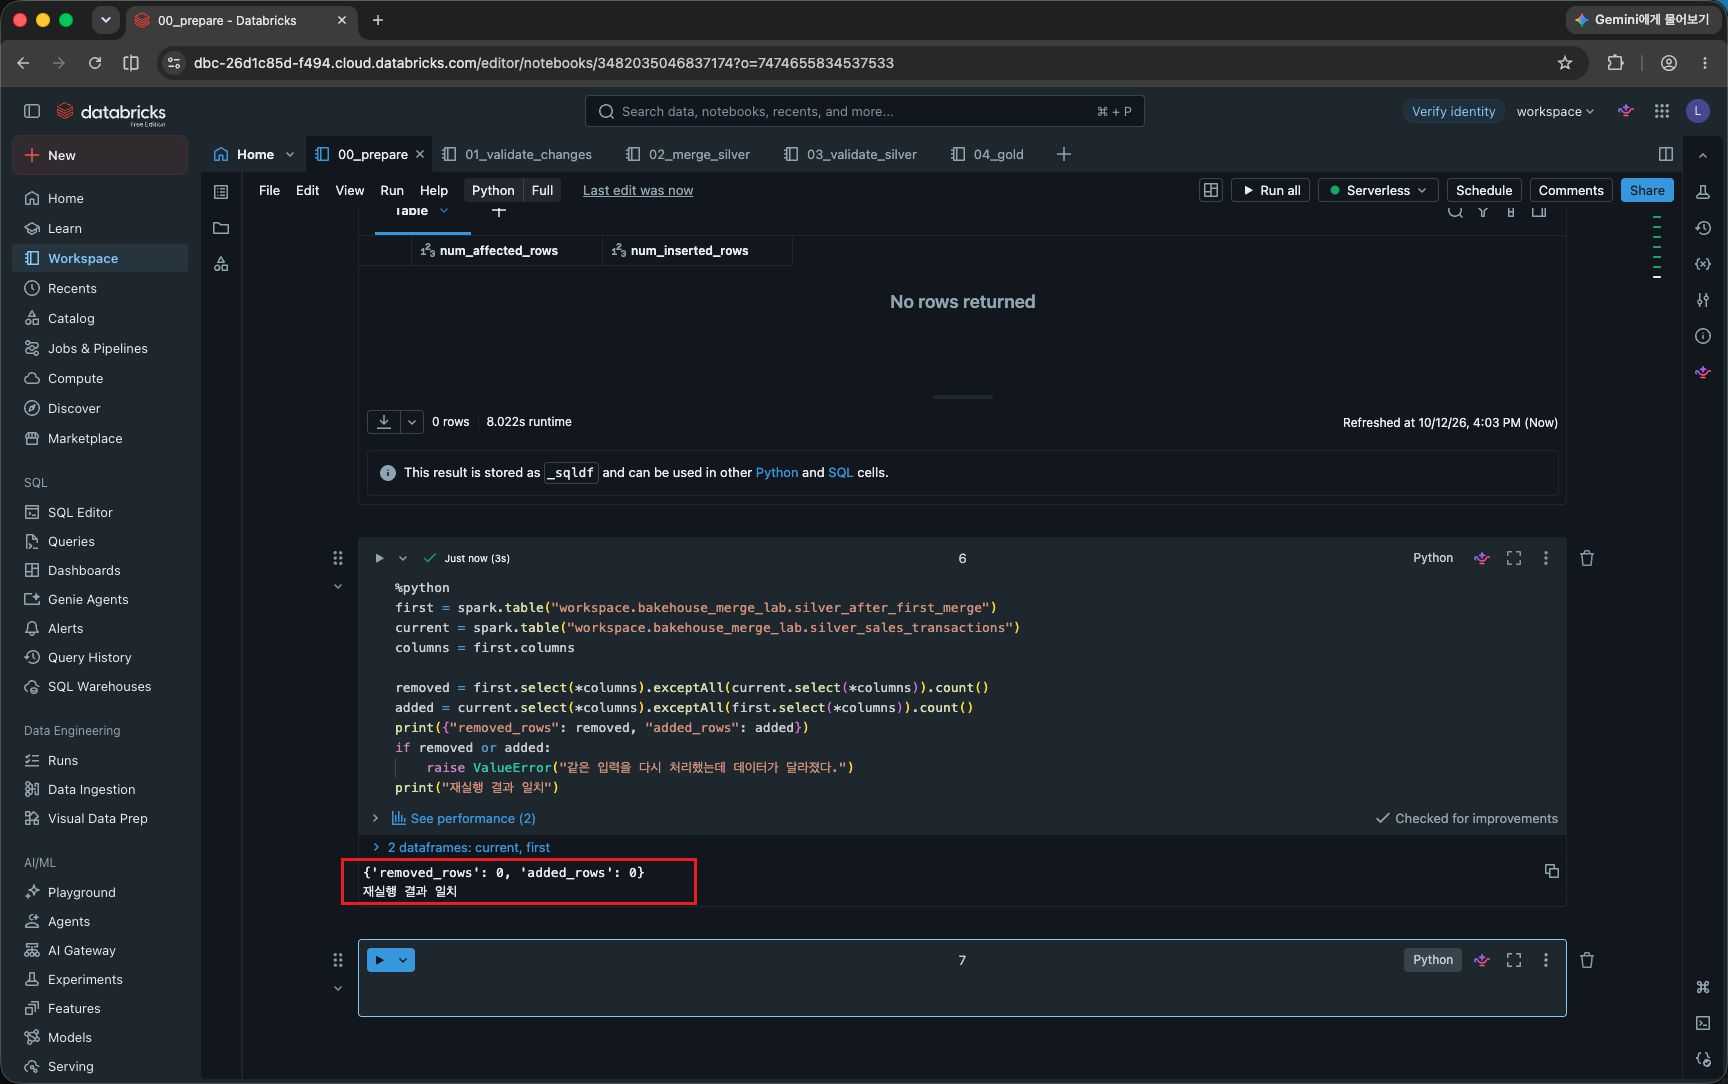
두 차이가 0이면 같은 입력을 다시 적용해도 테이블의 논리적 내용이 같다는 것을 확인한 것이다. 이런 성질을 멱등성이라고 한다. MERGE가 다시 실행되는 동안 파일이나 테이블 버전이 전혀 바뀌지 않는다는 의미는 아니다.
키의 유일성, 고정된 입력, 입력 값으로 교체하는 갱신 규칙이 이 예제의 멱등성을 만든다. MERGE라는 명령만으로 모든 처리의 멱등성이 보장되지는 않는다.
00_prepare의 비교 셀에서 removed_rows = 0, added_rows = 0과 재실행 결과 일치가 출력됐다.
5. Gold에도 정정된 결과 반영하기
Silver 갱신이 끝나도 기존 Gold가 저절로 바뀌지는 않는다. 04_gold에 다음 코드를 넣고 실행한다. 이번에는 작은 표본이므로 Silver 전체를 다시 집계해 Gold를 교체한다.
| |
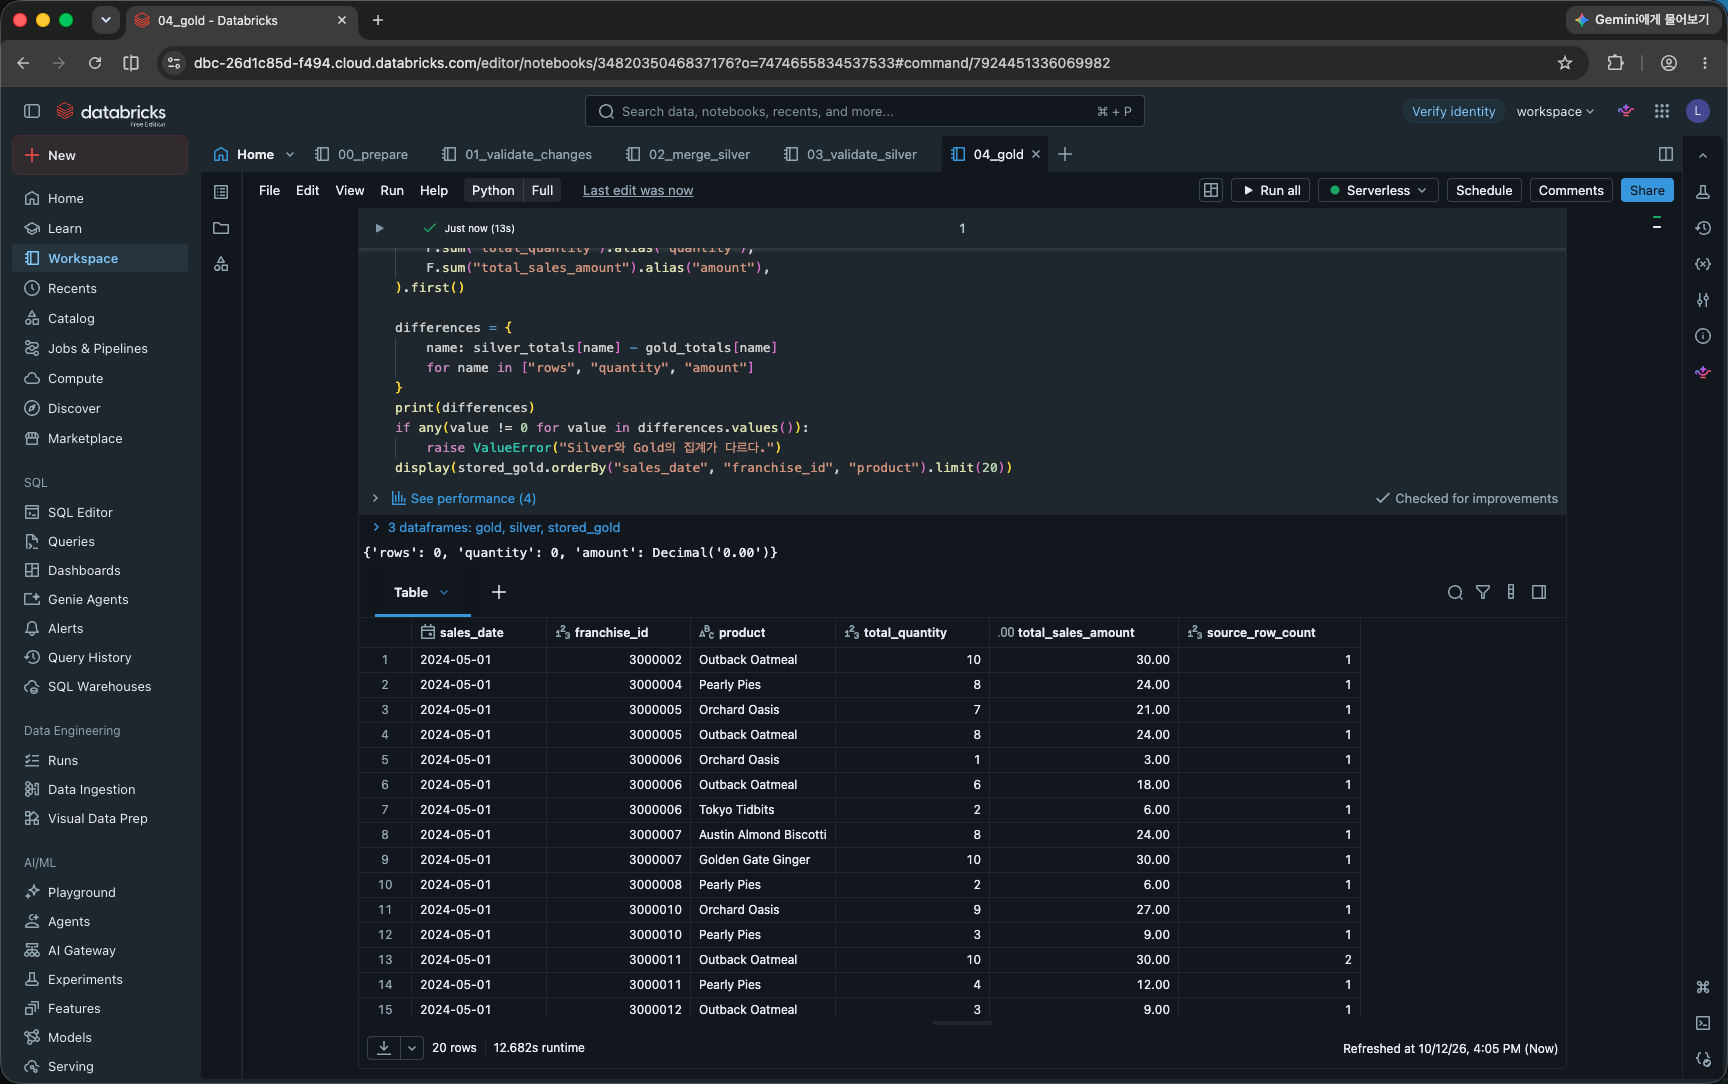
세 차이는 모두 0이어야 한다. rows는 Gold의 행 수가 아니라 집계에 포함한 상세 행 수를 합한 값이다.
이번 변경 두 행은 같은 날짜·매장·상품 그룹에 속한다. 아래 SQL로 그 그룹을 찾아 기준 데이터의 집계와 비교한다. 00_prepare의 새 셀에서 실행하면 된다.
| |
대상 그룹의 수량은 2, 금액은 25.00 늘어야 한다. 전체 합계와 실제 영향을 받은 그룹을 함께 살펴보는 것이다.
Gold를 저장한 뒤 상세 행 수와 수량의 차이는 0, 금액 차이는 Decimal('0.00')으로 출력됐다. 이 화면은 전체 합계 검산 결과이며, 특정 그룹의 변경 전후는 위 SQL로 별도 대조한다.
Silver의 변경분 반영과 Gold의 전체 재집계는 서로 다른 처리 방식이다. 대용량 데이터에서는 영향받은 그룹만 재계산하는 방법도 고려할 수 있지만, 날짜·상품 같은 그룹 키가 정정되면 이전 그룹과 새 그룹을 모두 갱신해야 한다. 이번에는 그 복잡도를 넣지 않는다.
6. 변경 반영을 Jobs로 연결하기
수동 실행을 확인했으면 3편과 같은 방법으로 **새 job bakehouse-merge**를 만든다. 기존 bakehouse-medallion job은 그대로 두고, 이번 폴더의 Notebook 네 개를 선택한다.
| Task name | Notebook | Depends on | Run if |
|---|---|---|---|
validate_changes | 01_validate_changes | 없음 | 기본값 |
merge_silver | 02_merge_silver | validate_changes | All succeeded |
validate_silver | 03_validate_silver | merge_silver | All succeeded |
gold | 04_gold | validate_silver | All succeeded |
Type은 Notebook, Source는 Workspace로 설정하고 Path 선택 창에서 각 Notebook을 고른다. Compute는 Serverless를 사용한다. 별도 라이브러리 설치나 task 파라미터는 필요하지 않다. 실행 주체에는 이번 schema와 테이블을 읽고 생성·갱신할 권한이 있어야 한다. Notebook task
실행 흐름은 입력 검사 → 변경 반영 → 반영 결과 검사 → Gold 갱신이다. All succeeded로 연결하면 앞선 검사가 실패했을 때 후속 task가 실행되지 않는다. 작업 의존 관계
00_prepare와 첫 반영 비교용 테이블 생성은 job에 넣지 않는다. 넣으면 매번 Silver를 초기화하거나 비교 기준을 새로 만들어 재실행을 확인할 수 없게 된다. Maximum concurrent runs는 1로 두고, 같은 테이블을 수동 Notebook에서도 동시에 갱신하지 않는다. 동시 실행 설정
이번에는 예약 트리거를 추가하기 전에 Run now로 두 번 실행한다.
- 네 task가 모두 성공했는지 확인한다.
validate_silver출력에서 초기 기준 대비 증가분이 1행·수량 2·금액 25.00인지 확인한다.gold의 합계 차이가 모두 0인지 확인한다.- 같은 job을 한 번 더 실행하고 같은 결과인지 확인한다.
- 4절의 ‘같은 입력을 한 번 더 반영하기’에서 작성한 비교용 Python 셀을 다시 실행한다. 첫 MERGE 직후 보관한
silver_after_first_merge와 현재silver_sales_transactions를 비교해removed_rows,added_rows가 모두 0인지 확인한다.
이때 silver_after_first_merge를 만드는 SQL 셀은 다시 실행하지 않는다. 다시 만들면 첫 반영 결과를 현재 데이터로 덮어써 비교 기준이 사라진다.
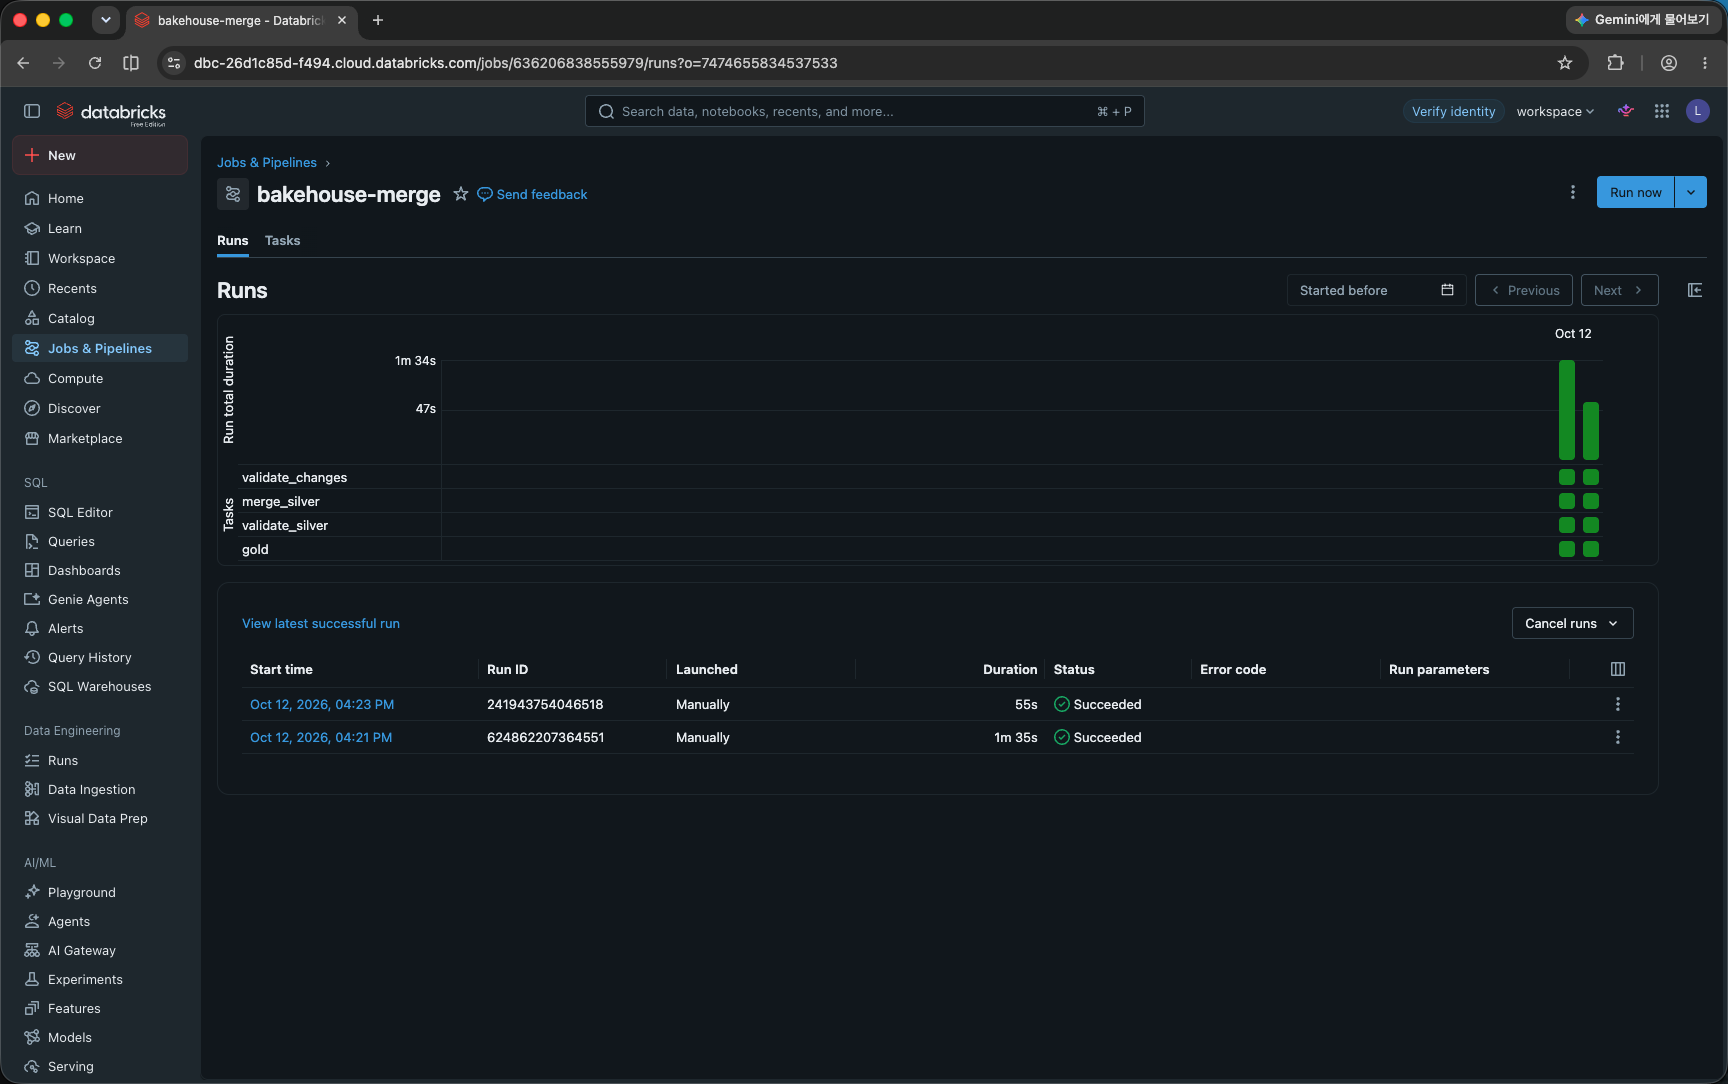
Runs 화면에는 두 번의 수동 실행이 모두 Succeeded로 표시됐고, 각 실행의 네 task도 모두 성공했다. Jobs 실행 뒤 00_prepare의 비교용 Python 셀을 다시 실행한 결과, 추가·제거 행이 모두 0으로 유지됐다.
고정된 변경 입력을 반복해서 적용하는 실습이므로 새로운 데이터가 계속 들어오지는 않는다. 운영으로 확장하려면 입력 배치를 수집·고정하는 단계와 처리한 배치를 추적하는 흐름을 추가해야 한다.
MERGE 이후에도 남는 운영 문제
이번 코드는 한 배치의 신규·정정 데이터와 재실행을 다뤘다. 실제 파이프라인에서는 변경이 도착한 순서와 데이터가 바뀐 순서가 같지 않을 수 있다. 더 최근의 정정 뒤에 오래된 입력을 반영하면 현재 값이 과거 값으로 돌아간다. 원천의 변경 시각이나 순번을 보존하고 어떤 변경을 우선할지 정해야 한다.
또한 Silver 반영과 Gold 갱신은 별도 작업이다. Silver가 성공한 뒤 Gold가 실패하면 두 계층의 갱신 시점이 달라진다. 이번처럼 입력을 고정하고 재실행해도 같은 결과를 만드는 규칙은 다시 처리하는 데 도움이 되지만, 전체 job을 한 번의 트랜잭션으로 만드는 것은 아니다.
이번 실습에서 확인할 핵심은 같은 판매 내역을 판단할 키, 정정 후 값을 저장하는 규칙, 재실행을 검증할 기준점이다. 실행 순서를 자동화하는 것에 더해 이 세 가지를 갖춰야, 실패 후 같은 입력을 다시 처리하는 흐름을 설명할 수 있다.
시리즈
Databricks 기초
- [Databricks] 무엇을 하는 플랫폼이고, 어떤 장점이 있을까? - 1편
- [Databricks] 메달리온 아키텍처 실습: Bronze·Silver·Gold 테이블 만들기 - 2편
- [Databricks] Lakeflow Jobs 실습: Bronze·Silver·Gold 작업 자동화하기 - 3편
- [Databricks] Delta Lake MERGE 실습: 신규·정정 데이터 반영하기 - 4편 현재 글
- [Databricks] CSV 수집 실습: Volume에서 Bronze로 적재하기 - 5편